
参数的点估计给出了一个具体的数值,便于计算和使用,但其精度如何,点估计本身不能回答,需要由其分布来反映.实际中,度量一个点估计的精度的最直观的方法就是给出未知参数的一个区间,这便产生区间估计的概念.
6.6.1 区间估计的概念
Section titled “6.6.1 区间估计的概念”设 θ 是总体的一个参数,x₁, x₂, …, xₙ 是样本,所谓区间估计就是要找两个统计量 hatθ_(L) = hatθ_(L)(x₁, x₂, …, xₙ) 和 hatθ_(U) = hatθ_(U)(x₁, x₂, …, xₙ),使得 hatθ_(L) < hatθ_(U),在得到样本观测值之后,就把 θ 估计在区间 [hatθ_(L), hatθ_(U)] 内.由于样本的随机性,区间 [hatθ_(L), hatθ_(U)] 盖住未知参数 θ 的可能性并不确定,人们通常要求区间 [hatθ_(L), hatθ_(U)] 盖住 θ 的概率 P(hatθ_(L) ≤slant θ ≤slant hatθ_(U)) 尽可能大,但这必然导致区间长度增大,为解决此矛盾,把区间 [hatθ_(L), hatθ_(U)] 盖住 θ 的概率 (以后称为置信水平) 事先给定,这就引入如下置信区间的概念.
设 θ 是总体的一个参数,其参数空间为 Θ, x₁, x₂, …, xₙ 是来自该总体的样本,对给定的一个 α (0 < α < 1),假设有两个统计量 hatθ_(L) = hatθ_(L)(x₁, x₂, …, xₙ) 和 hatθ_(U) = hatθ_(U)(x₁, x₂, …, xₙ),若对任意的 θ ∈ Θ,有
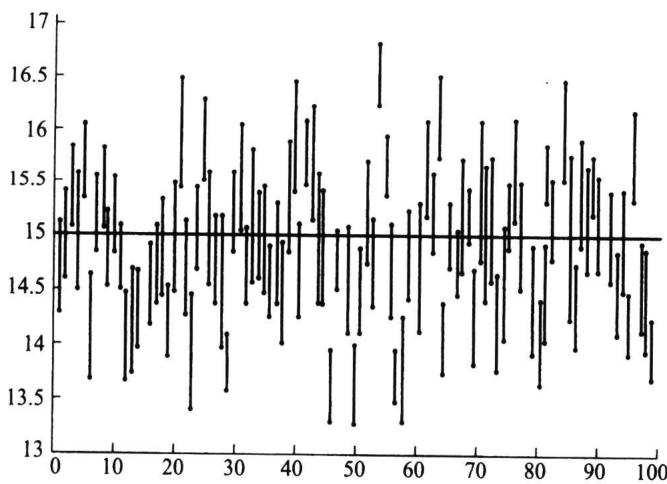
P _ θ (hat θ _ L ≤slant θ ≤slant hat θ _ U) ≥slant 1 - α , (6.6.1)则称随机区间 [hatθ_L, hatθ_U] 为 θ 的置信水平为 1 - α 的置信区间,或简称 [hatθ_L, hatθ_U] 是 θ 的 1 - α 置信区间, hatθ_L 和 hatθ_U 分别称为 θ 的(双侧)置信下限和置信上限. 置信水平 1 - α 有一个频率解释: 在大量重复使用 θ 的置信区间 [hatθ_L, hatθ_U] 时,每次得到的样本观测值是不同的,从而每次得到的区间也是不一样的.对一次具体的观测值而言,θ 可能在 [hatθ_L, hatθ_U] 内,也可能不在.平均而言,在这大量的区间估计观测值中,至少有 100(1 - α)% 包含 θ.下例中的图 6.6.1和图 6.6.2直观地显示了该种频率意义.
设 x₁, x₂, …, x₁0 是来自 N(μ, σ²) 的样本,则 μ 的置信水平为 1 - α 的置信区间为
[ bar x - t _ 1 - α / 2 (9) s / sqrt 1 0, bar x + t _ 1 - α / 2 (9) s / sqrt 1 0 ],其中 barx, s 分别为样本均值和样本标准差.这个置信区间的由来将在 6.6.3 节中说明,这里用它来说明置信区间与置信水平的含义. 若取 α = 0.10 ,则 t₀.95(9) = 1.8331 ,上式化为
[ overline x - 0. 5 7 9 7 s, overline x + 0. 5 7 9 7 s ].现假定 μ = 15, σ² = 4 ,则我们可以用随机模拟方法由 N(15,4) 产生一个容量为 10 的样本,如下即是这样一个样本:
l l l l l 1 4. 8 5 & 1 3. 0 1 & 1 3. 5 0 & 1 4. 9 3 & 1 6. 9 7l l l l l 1 3. 8 0 & 1 7. 9 5 & 1 3. 3 7 & 1 6. 2 9 & 1 2. 3 8由该样本可以算得
overline x = 1 4. 7 0 5, s = 1. 8 4 3.从而得到 μ 的一个区间估计为
[ 1 4. 7 0 5 ∓ 0. 5 7 9 7 × 1. 8 4 3 ] = [ 1 3. 6 3 7, 1 5. 7 7 3 ],该区间包含 μ 的真值——15. 现重复这样的方法 100 次,可以得到 100 个样本,也就得到 100 个区间,我们将这 100 个区间画在图 6.6.1 上.由图 6.6.1 可以看出,这 100 个区间中有 91 个包含参数真值 15, 另外 9 个不包含参数真值.这是置信水平 1 - α = 0.90 的一个合理解释. 若取 α=0.50 ,则 t₀.75(9)=0.7027 ,于是 μ 的置信水平为 0.50 的置信区间为
[ overline x - 0. 2 2 2 2 s, overline x + 0. 2 2 2 2 s ].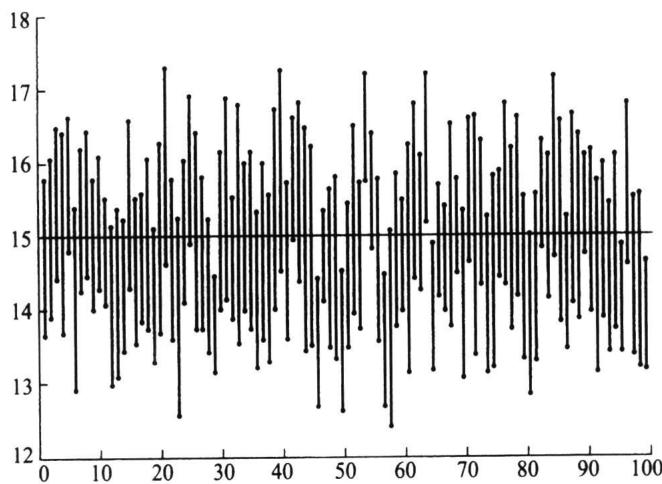
对上述样本,μ 的区间估计为
[ 1 4. 7 0 5 ∓ 0. 2 2 2 2 × 1. 8 4 3 ] = [ 1 4. 2 9 5, 1 5. 1 1 5 ],该区间也包含了参数真值,类似地,我们也可以给出100个这样的区间,见图 6.6.2 的一个合理解释.当然,若换100个样本,也不一定正好50%包含真值,但应差不多,譬如,49个或51个都是合理的. 在定义6.6.1 中使用不等式给出了区间估计的定义,主要是照顾到总体为离散分布场合.而当总体为连续分布场合,为了用足置信水平,实际中常用的都是等式,这便图 6.6.2可以看出,这100个区间中有50个包含参数真值15,另外50个不包含参数真值.这是置信水平 1-α=0.50 的一个合理解释.当然,若换100个样本,也不一定正好50%包含真值,但应差不多,譬如,49个或51个都是合理的. 在定义 6.6.1 中使用不等式给出了区间估计的定义,主要是照顾到总体为离散分布场合.而当总体为连续分布场合,为了用足置信水平,实际中常用的都是等式,这便
给出如下一个定义.
沿用定义6.6.1 的记号,如对给定的 α(0<α<1),对任意的 θ∈Θ,有
P _ θ (hat θ _ L ≤slant θ ≤slant hat θ _ U) = 1 - α , (6.6.2)则称 [hatθ_L, hatθ_U] 为 θ 的 1 - α 同等置信区间. 在一些实际问题中,人们感兴趣的有时仅仅是未知参数的一个下限或一个上限.譬如,对某种产品的平均寿命来说,我们希望它越大越好,因此人们关心的是它的0.90置信下限是多少,此下限标志了该产品的质量,它的一般定义如下.
设 hatθ_(L) = hatθ_(L)(x₁, x₂, …, xₙ) 是统计量,对给定的 α ∈ (0, 1) 和任意的 θ ∈ Θ ,有
P _ θ (hat θ _ L ≤slant θ) ≥slant 1 - α , ∀ θ ∈ Θ , (6.6.3)则称 hatθ_L 为 θ 的置信水平为 1 - α 的(单侧)置信下限.假如等号对一切 θ ∈ Θ 成立,则称 hatθ_L 为 θ 的 1 - α 同等置信下限. 类似地,对某些指标人们希望它越小越好.比如,某种药品的毒性.这引出了置信上限的概念.
设 hatθ_(U) = hatθ_(U)(x₁, x₂, …, xₙ) 是统计量,对给定的 α ∈ (0, 1) 和任意的 θ ∈ Θ ,有
P _ θ (hat θ _ U ≥slant θ) ≥slant 1 - α , (6.6.4)则称 hatθ_U 为 θ 的置信水平为 1 - α 的(单侧)置信上限.若等号对一切 θ ∈ Θ 成立,则称 hatθ_U 为 θ 的 1 - α 同等置信上限. 不难看出,单侧置信下限和单侧置信上限都是置信区间的特殊情形.因此,寻求置信区间的方法可以用来寻找置信限.接下来我们主要介绍寻找置信区间的方法.
6.6.2 枢轴量法
Section titled “6.6.2 枢轴量法”构造未知参数 θ 的置信区间的最常用的方法是枢轴量法,其步骤可以概括为如下 三步: (1)设法构造一个样本和 θ 的函数 G = G(x₁, x₂, …, xₙ, θ) 使得 G 的分布不依赖于未知参数。一般称具有这种性质的 G 为枢轴量。 (2) 适当地选择两个常数 c, d,使对给定的 α (0 < α < 1),有
P (c ≤slant G ≤slant d) = 1 - α . (6.6.5)在离散场合,上式等号改为大于等于(≥). (3) 假如能将 c ≤slant G ≤slant d 进行不等式等价变形化为 hatθ_(L) ≤slant θ ≤slant hatθ_(U) ,则有
P _ θ (hat θ _ L ≤slant θ ≤slant hat θ _ U) = 1 - α , (6.6.6)这表明 [hatθ_L, hatθ_U] 是 θ 的 1 - α 同等置信区间. 上述构造置信区间的关键在于构造枢轴量 G ,故把这种方法称为枢轴量法。枢轴量的寻找一般从 θ 的点估计出发。而满足(6.6.5)的 c, d 可以有很多,选择的目的是希望(6.6.6)中的平均长度 E_(θ)(hatθ_(U)-hatθ_(L)) 尽可能短。 假如可以找到这样的 c, d 使 E_(θ)(hatθ_U - hatθ_L) 达到最短当然是最好的,不过在不少场合很难做到这一点。故常这样选择 c 和 d ,使得两个尾部概率各为 α / 2 ,即
P _ θ (G < c) = P _ θ (G > d) = α / 2, (6.6.7)这样得到的置信区间称为等尾置信区间.实用的置信区间大都是等尾置信区间.
设 x₁, x₂, …, xₙ 是来自均匀总体 U(0, θ) 的一个样本,试对设定的 α (0 < α < 1) 给出 θ 的 1 - α 同等置信区间.
解
我们采用枢轴量法分三步进行. (1)我们已知 θ 的最大似然估计为样本的最大次序统计量 x_((n)) ,而 x_((n)) / θ 的密度函数为
p (y; θ) = n y ^ n - 1, 0 < y < 1,它与参数 θ 无关,故可取 x_((n))/θ 作为枢轴量 G. (2)由于 x_((n)) / θ 的分布函数为 F(y) = yⁿ, 0 < y < 1 ,故 P(c ≤slant x_((n)) / θ ≤slant d) = dⁿ - cⁿ ,因此我们可以选择适当的 c 和 d 满足
d ^ n - c ^ n = 1 - α .(3)利用不等式变形可容易地给出 θ 的 1 - α 同等置信区间为 [x_((n)) / d, x_((n)) / c] ,该区间的平均长度为 (1/c - 1/d) E(x_((n))) 。不难看出,在 0 ≤slant c < d ≤slant 1 及 dⁿ - cⁿ = 1 - α 的条件下,当 d = 1, c = n√(α) 时, 1/c - 1/d 取最小值,这说明 [x_((n)), x_((n)) / n√(α)] 是 θ 的此类区间估计中置信水平为 1 - α 最短置信区间。
6.6.3 单个正态总体参数的置信区间
Section titled “6.6.3 单个正态总体参数的置信区间”正态总体 N(μ, σ²) 是最常见的分布,本小节中我们讨论它的两个参数的置信区间.
一、 σ 已知时 μ 的置信区间
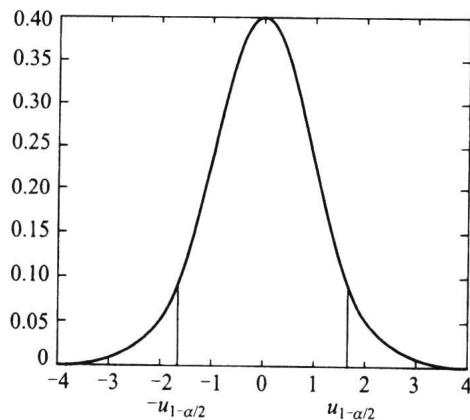
Section titled “一、 σσ 已知时 μμ 的置信区间”在这种情况下,由于 μ 的点估计为 barx,其分布为 N(μ, σ²/n),因此枢轴量可选为 G = fracbarx - μσ / √(n) ∼ N(0,1), c 和 d 应满足 P(c ≤slant G ≤slant d) = Φ(d) - Φ(c) = 1 - α ,经过不等式变形可得 P_(μ)(barx - dσ / √(n) ≤slant μ ≤slant barx - cσ / √(n)) = 1 - α ,该区间长度为 (d - c)σ / √(n).由于标准正态分布为单峰对称的,从图 6.6.3上不难看出在 Φ(d) - Φ(c) = 1 - α 的条件下,当 d = -c = u₁ - α / 2 时, d - c 达到最小,由此给出了 μ 的 1 - α 同等置信区间为
这是一个以 overlinex 为中心,半径为 u₁ - α /2σ /√(n) 的对称区间,常将之表示为 overlinex± u₁ - α /2σ /√(n)
用天平称量某物体的质量 9 次,得平均值为 barx = 15.4(g),已知天平称量结果为正态分布,其标准差为 0.1(g). 试求该物体质量的 0.95 置信区间.
解
此处 1 - α = 0.95, α = 0.05 ,查表知 u₀.975 = 1.96 ,于是该物体质量 μ 的0.95置信区间为
bar x ± u _ 1 - α / 2 σ / sqrt n = 1 5. 4 ± 1. 9 6 × 0. 1 / sqrt 9 = 1 5. 4 ± 0. 0 6 5 3,从而该物体质量的 0.95 置信区间为 [15.334 7, 15.465 3].
设总体为正态分布 N(μ,1) ,为得到 μ 的置信水平为 0.95 的置信区间且长度不超过 1.2,样本容量应为多大?
解
由题设条件知 μ 的0.95置信区间为
[ bar x - u _ 1 - α / 2 / sqrt n, bar x + u _ 1 - α / 2 / sqrt n ],其区间长度为 2u₁ - α /2 / √(n) ,它仅依赖于样本容量 n 而与样本具体取值无关.现要求 2u₁ - α /2 / √(n)≤slant 1.2 ,立即有 n≥slant (2 / 1.2)²u₁ - α /2².现 1 - α = 0.95 ,故 u₁ - α /2 = 1.96 ,从而 n≥slant (5 / 3)²× 1.96² = 10.67≈ 11. 即样本容量至少为11时才能使得 μ 的置信水平为0.95的置信区间长度不超过1.2.
二、 σ 未知时 μ 的置信区间
Section titled “二、 σσ 未知时 μμ 的置信区间”这时可用 t 统计量,因为 t = frac√(n)(barx - μ)s ∼ t(n - 1),因此 t 可以用来作为枢轴量.完全类似于上一小节,可得到 μ 的 1 - α 置信区间为
bar x ± t _ 1 - α / 2 (n - 1) s / sqrt n (6.6.9)此处 s² = (1)/(n - 1)∑ᵢ = 1ⁿ(xᵢ - overlinex)² 是 σ² 的无偏估计.
假设轮胎的寿命服从正态分布.为估计某种轮胎的平均寿命,现随机地抽12只轮胎试用,测得它们的寿命(单位:万千米)如下: 试求平均寿命的 0.95 置信区间.
解
此处正态总体标准差未知,可使用 t 分布求均值的置信区间.本例中经计算有 barx=4.7092, s²=0.0615.取 α=0.05,查表知 t₀.975(11)=2.2010,于是平均寿命的 0.95 置信区间为
4. 7 0 9 2 ± 2. 2 0 1 0 · sqrt 0 . 0 6 1 5 / sqrt 1 2 = [ 4. 5 5 1 6, 4. 8 6 6 8 ].在实际问题中,由于轮胎的寿命越长越好,因此可以只求平均寿命的置信下限,也即构造单侧的置信下限.由于
P (frac sqrt n (bar x - μ)s < t _ 1 - α (n - 1)) = 1 - α .由不等式变形可知 μ 的 1 - α 置信下限为 overlinex - t₁ - α(n - 1)s / √(n).将 t₀.95(11) = 1.7959 代入计算可得平均寿命 μ 的 0.95 置信下限为 4.5806 (万千米).
三、 σ² 的置信区间
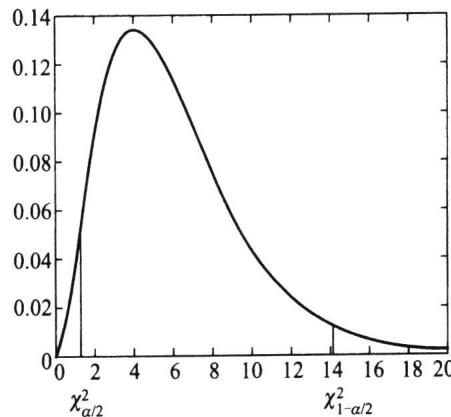
Section titled “三、 σ²σ2 的置信区间”此时虽然也可以就 μ 是否已知分两种情况讨论 σ² 的置信区间,在实际中 σ² 未知 时 μ 已知的情形是极为罕见的,所以我们只在 μ 未知的条件下讨论 σ² 的置信区间. 枢轴量不难给出.大家知道,σ² 可用样本方差 s² 估计.在§5.4中我们已经证明 frac(n-1)s²σ²∼χ²(n-1),由于 χ² 分布是偏态分布,寻找平均长度最短区间很难实现,一般都改为寻找等尾置信区间:把 α 平分为两部分,在 χ² 分布两侧各截面积为 α/2 的部分,即采用 χ² 的两个分位数 χ_(α/2)²(n-1) 和 χ₁-α/2²(n-1) (见图 6.6.4),它们满足
由此给出 σ² 的 1 - α 置信区间为
[ (n - 1) s ^ 2 / χ_ 1 - α / 2 ^ 2 (n - 1), (n - 1) s ^ 2 / χ_ α / 2 ^ 2 (n - 1) ]. (6.6.10)将(6.6.10)的两端开方即得到标准差 σ 的 1-α 置信区间.
某厂生产的零件重量服从正态分布 N(μ, σ²) ,现从该厂生产的零件中抽取 9 个,测得其质量(单位:g)为
4 5. 3 4 5. 4 4 5. 1 4 5. 3 4 5. 5 4 5. 7 4 5. 4 4 5. 3 4 5. 6试求总体标准差 σ 的 0.95 置信区间.
解
由数据可算得 s² = 0.0325, (n - 1)s² = 8 × 0.0325 = 0.26 ,这里 α = 0.05 ,查表知 χ²₀.025(8) = 2.1797, χ²₀.975(8) = 17.5345 ,代入(6.6.10)式可得 σ² 的0.95置信区间为
[ frac 0 . 2 61 7 . 5 3 4 5, frac 0 . 2 62 . 1 7 9 7 ] = [ 0. 0 1 4 8, 0. 1 1 9 3 ].从而 σ 的 0.95 置信区间为 [0.1218, 0.3454].
6.6.4 大样本置信区间
Section titled “6.6.4 大样本置信区间”在有些场合,寻找枢轴量及其分布比较困难.在样本量充分大时,可用渐近分布来构造近似的置信区间,一个典型的例子是关于比例 p 的置信区间. 设 x₁, x₂, …, xₙ 是来自二点分布 b(1, p) 的样本,现要求 p 的 1 - α 置信区间。由中心极限定理知,样本均值 barx 的渐近分布为 N(p, (p(1 - p))/(n)) ,因此有
u = frac overline x - psqrt p (1 - p) / n ÷ N (0, 1).这个 u 可作为近似枢轴量,对给定 α,利用标准正态分布的 1-α/2 分位数 u₁-α/2 可得
P g (| frac overline x - psqrt p (1 - p) / n | ≤slant u _ 1 - α / 2 g) ≈ 1 - α ,括号里的事件等价于
(overline x - p) ^ 2 ≤slant u _ 1 - α / 2 ^ 2 p (1 - p) / n,记 λ = u₁ - α /2² ,上述不等式可化为
(1 + frac λn) p ^ 2 - (2 bar x + frac λn) p + bar x ^ 2 ≤slant 0,左侧 p 的二次三项式的判别式
(2 bar x + frac λn) ^ 2 - 4 (1 + frac λn) bar x ^ 2 = frac 4 bar x (1 - bar x)n λ + frac λ^ 2n ^ 2 > 0,故此二次三项式的图形是开口向上并与 x 轴有两个交点的曲线(见图 6.6.5).记此两个交点的横坐标为 hatp_L 和 hatp_U ,则有
P (hat p _ L ≤slant p ≤slant hat p _ U) = 1 - α .这里 hatp_L 和 hatp_U 是该二次三项式的两个根,它们可表示为
frac 11 + frac λn (bar x + frac λ2 n ± sqrt frac bar x (1 - bar x)n λ + frac λ^ 24 n ^ 2).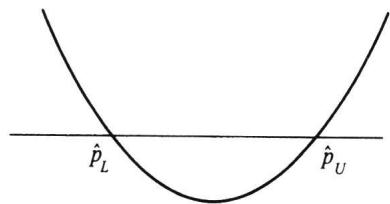
由于 n 比较大,在实用中通常略去 λ / n 项,于是可将置信区间近似为
[ bar x - u _ 1 - α / 2 sqrt frac bar x (1 - bar x)n, bar x + u _ 1 - α / 2 sqrt frac bar x (1 - bar x)n ]. (6.6.11)对某事件 A 作 120 次观察,A 发生 36 次.试给出事件 A 发生概率 p 的 0.95 置信区间.
解
此处 n = 120, barx = 36 / 120 = 0.3 ,而 u₀.975 = 1.96 ,于是 p 的 0.95(双侧)置信下限和上限分别为
hat p _ L = 0. 3 - 1. 9 6 × sqrt frac 0 . 3 × 0 . 71 2 0 = 0. 2 1 8,hat p _ U = 0. 3 + 1. 9 6 × sqrt frac 0 . 3 × 0 . 71 2 0 = 0. 3 8 2,故所求的近似置信区间为[0.218,0.382]. 关于泊松分布中参数 λ 的置信区间亦可用类似方法确定,见习题 6.6 第 7 题.
6.6.5 样本量的确定
Section titled “6.6.5 样本量的确定”在统计中,样本量越大,估计的精度越高,但大样本量需要的经费高,实施的时间也长,投入人力也多,所以实用中人们往往关心如下问题:在一定要求下,至少需要多大的样本量?这就是样本量的确定问题. 样本量的确定有多种方法,不同场合使用不同方法.这里介绍估计比率 p 所需样本量.很多实际问题都需要估计比率,如不合格品率、吸烟率、新生儿中男婴出生率、某项政策支持率等.在这些场合至少需要多大样本量才能保证所得估计得到一定精度呢?下面通过一个具体例子讨论该问题.
某传媒公司欲调查电视台某综艺节目收视率 p,为使得 p 的 1-α 置信区间长度不超过 2d₀ ,问应至少调查多少用户? 这是典型的抽样调查问题,在抽样调查中,置信水平 1-α 也称为保证概率,置信区间的半径(长度的一半) d₀ 也称为绝对误差.
解
这是关于二点分布比例 p 的置信区间问题,由(6.6.11)式知,p 的 1 - α 近似置信区间半径为 u₁ - α /2sqrtbarx(1 - barx) / n,这是一个随机变量,但由于 barx ∈ (0,1),所以对任意的观测值有 barx(1 - barx) ≤slant 0.5² = 0.25.这也就是说 p 的 1 - α 的置信区间半径不会超过 u₁ - α /2 / (2√(n)).现要求 p 的 1 - α 的置信区间半径不超过 d₀,只需要 u₁ - α /2 / (2√(n)) ≤slant d₀ 即可,从而
n ≥slant (frac u _ 1 - α / 22 d _ 0) ^ 2. (6.6.12)这是在估计比例 p 场合确定样本量的公式.比如,若取 d₀ = 0.02, α = 0.05 ,则
n ≥slant (frac u _ 0 . 9 7 50 . 0 4) ^ 2 = (frac 1 . 9 60 . 0 4) ^ 2 = 2 4 0 1.这表明,要使综艺节目收视率 p 的 0.95 置信区间的半径不超过 0.02,则至少需要对 2401 个用户作调查.或者说,至少需调查 2401 个用户,才能以概率 0.95 保证调查所得比例估计值 hatp 与真值 p 的差异不大于 0.02. 表 6.6.1 给出了部分常见的要求下样本量的结果,可以看到,若要置信区间长度小而置信水平高,则可能需要很大的样本量. 表 6.6.1 部分 ( 1 - α ,d₀) 组合下的样本量
| 1-α | 2d₀ | |||||||
| 0.005 | 0.01 | 0.02 | 0.03 | 0.04 | 0.05 | 0.1 | 0.2 | |
| 0.8 | 65 695 | 16 424 | 4 106 | 1 825 | 1 027 | 657 | 165 | 42 |
| 0.85 | 82 891 | 20 723 | 5 181 | 2 303 | 1 296 | 829 | 208 | 52 |
| 0.9 | 108 222 | 27 056 | 6 764 | 3 007 | 1 691 | 1 083 | 271 | 68 |
| 0.95 | 153 659 | 38 415 | 9 604 | 4 269 | 2 401 | 1 537 | 385 | 97 |
| 0.99 | 265 396 | 66 349 | 16 588 | 7 373 | 4 147 | 2 654 | 664 | 166 |
6.6.6 两个正态总体下的置信区间
Section titled “6.6.6 两个正态总体下的置信区间”设 x₁, x₂, …, xₘ 是来自 N(μ₁, σ₁²) 的样本, y₁, y₂, …, yₙ 是来自 N(μ₂, σ₂²) 的样本,且两个样本相互独立。 barx 与 bary 分别是它们的样本均值, sₓ² = (1)/(m - 1) ∑ᵢ=1^(m) (xᵢ - barx)² 和 s_(y)² = (1)/(n - 1) ∑ᵢ=1ⁿ (yᵢ - bary)² 分别是它们的样本方差。下面讨论两个均值差和两个方差比的置信区间。
一、 μ₁-μ₂ 的置信区间
Section titled “一、 μ₁-μ₂μ1−μ2 的置信区间”它的几种特殊情况已获得圆满的解决.下面我们对此问题分几种情况分别叙述,读者应留意它们之间的差别及其处理方法.
- σ₁² 和 σ₂² 已知时 此时有 overlinex -overliney∼ N(μ₁ - μ₂,fracσ₁²m +fracσ₂²n) ,取枢轴量为
沿用前面多次用过的方法可以得到 μ₁-μ₂ 的 1-α 置信区间为
overline x - overline y ± u _ 1 - α / 2 sqrt frac σ_ 1 ^ 2m + frac σ_ 2 ^ 2n- σ₁² = σ₂² = σ² 未知时 此时有
由于 barx,bary,sₓ²,s_(y)² 相互独立,故可构造如下服从t分布 t(m+n-2) 的枢轴量
t = sqrt frac m n (m + n - 2)m + n frac bar x - bar y - (μ_ 1 - μ_ 2)sqrt (m - 1) s _ x ^ 2 + (n - 1) s _ y ^ 2 ∼ t (m + n - 2).记 s_w² = ((m - 1)sₓ² + (n - 1)s_y²)/(m + n - 2) ,则 μ₁ - μ₂ 的 1 - α 置信区间为
overline x - overline y ± sqrt frac m + nm n s _ w t _ 1 - α / 2 (m + n - 2)- σ₂² / σ₁² = c 已知时 此时的处理方法与2中完全类似,只需注意到
由于 overlinex,overliney,sₓ²,s_y² 相互独立,仍可构成为如下服从 t 分布 t(m + n - 2) 的枢轴量
t = frac bar x - bar y - (μ_ 1 - μ_ 2)sqrt (m - 1) s _ x ^ 2 + (n - 1) s _ y ^ 2 / c sqrt frac m n (m + n - 2)m c + n ∼ t (m + n - 2),记 s_w² = ((m - 1)sₓ² + (n - 1)s_y² / c)/(m + n - 2) ,则 μ₁ - μ₂ 的 1 - α 置信区间为
overline x - overline y ± sqrt frac m c + nm n s _ w t _ 1 - α / 2 (m + n - 2),- 当 m 和 n 都很大时的近似置信区间 若对 σ₁²,σ₂² 没有什么信息,当 m,n 都很大时,由中心极限定理知
由此可给出 μ₁ - μ₂ 的 1 - α 近似置信区间为
overline x - overline y ± u _ 1 - α / 2 sqrt frac s _ x ^ 2m + frac s _ y ^ 2n.5. 一般情况下的近似置信区间
Section titled “5. 一般情况下的近似置信区间”若对 σ₁², σ₂² 没有什么信息, m, n 也不很大,求 μ₁ - μ₂ 的精确置信区间是历史上著名的贝伦斯-费希尔(Behrens-Fisher)问题,它是贝伦斯在1929年从实际中提出的问题,至今还有学者在做研究。这里介绍一种近似方法:令 s₀² = sₓ² / m + s_y² / n ,取近似枢轴量
T = [ bar x - bar y - (μ_ 1 - μ_ 2) ] / s _ 0,此时 T 不服从 N(0,1) ,但近似服从自由度为 l 的 t 分布,其中 l 由公式
l = frac s _ 0 ^ 4frac s _ x ^ 4m ^ 2 (m - 1) + frac s _ y ^ 4n ^ 2 (n - 1)决定, l 一般不为整数,可以取与 l 最接近的整数代替之.于是,近似地有 T∼ t(l) ,从而可得 μ₁ - μ₂ 的 1 - α 近似置信区间为
overline x - overline y ± s _ 0 t _ 1 - α / 2 (l).为比较两个小麦品种的产量,选择 18 块条件相似的试验田,采用相同的耕作方法做试验,结果播种甲品种的 8 块试验田的单位面积产量和播种乙品种的 10 块试验田的单位面积产量(单位:kg)分别为
l l l l l l l l l l l text 甲品种: & 6 2 8 & 5 8 3 & 5 1 0 & 5 5 4 & 6 1 2 & 5 2 3 & 5 3 0 & 6 1 5 text 乙品种: & 5 3 5 & 4 3 3 & 3 9 8 & 4 7 0 & 5 6 7 & 4 8 0 & 4 9 8 & 5 6 0 & 5 0 3 & 4 2 6假定每个品种的单位面积产量均服从正态分布,试求这两个品种平均单位面积产量差的 1-α 置信区间(取 α=0.05 ).
解
以 x₁, x₂, …, x₈ 记甲品种的单位面积产量,y₁, y₂, …, y₁0 记乙品种的单位面积产量,由样本数据可计算得到
l l overline x = 5 6 9. 3 8, & s _ x ^ 2 = 2 1 4 0. 5 5, m = 8, overline y = 4 8 7. 0 0, & s _ y ^ 2 = 3 2 5 6. 2 2, n = 1 0,下面分两种情况讨论. (1) 若已知两个品种单位面积产量的标准差相等,则可采用二样本 t 区间.此处
r l & s _ w = sqrt frac (m - 1) s _ x ^ 2 + (n - 1) s _ y ^ 2m + n - 2 = sqrt frac 7 × 2 1 4 0 . 5 5 + 9 × 3 2 5 6 . 2 21 6 = 5 2. 6 1 2 9, & t _ 1 - α / 2 (m + n - 2) = t _ 0. 9 7 5 (1 6) = 2. 1 1 9 9,t _ 1 - α / 2 (m + n - 2) s _ w sqrt frac 1m + frac 1n = 2. 1 1 9 9 × 5 2. 6 1 2 9 × sqrt frac 18 + frac 11 0 = 5 2. 9 1,故 μ₁ - μ₂ 的0.95置信区间为
[ 5 6 9. 3 8 - 4 8 7 ± 5 2. 9 1 ] = [ 2 9. 4 7, 1 3 5. 2 9 ].(2) 若两个品种单位面积产量的方差不等,则可采用近似 t 区间.此处
s _ 0 ^ 2 = 2 1 4 0. 5 5 / 8 + 3 2 5 6. 2 2 / 1 0 = 5 9 3. 1 9, s _ 0 = 2 4. 3 6,l = frac 5 9 3 . 1 9 ^ 2frac 2 1 4 0 . 5 5 ^ 28 ^ 2 × 7 + frac 3 2 5 6 . 2 2 ^ 21 0 ^ 2 × 9 = 1 5. 9 9 ≈ 1 6,s _ 0 t _ 0. 9 7 5 (l) = 2 4. 3 6 × 2. 1 1 9 9 = 5 1. 6 4,于是 μ₁-μ₂ 的 0.95 近似置信区间为
[ 5 6 9. 3 8 - 4 8 7 ± 5 1. 6 4 ] = [ 3 0. 7 4, 1 3 4. 0 2 ].二、 σ₁²/σ₂² 的置信区间
Section titled “二、 σ₁²/σ₂²σ12/σ22 的置信区间”由于 (m - 1)sₓ² /σ₁²∼ χ² (m - 1),(n - 1)s_y² /σ₂²∼ χ² (n - 1) ,且 sₓ² 与 s_y² 相互独立,故可仿照 F 变量构造如下枢轴量:
F = frac s _ x ^ 2 / σ_ 1 ^ 2s _ y ^ 2 / σ_ 2 ^ 2 ∼ F (m - 1, n - 1),对给定的置信水平 1 - α ,由
P (F _ α / 2 (m - 1, n - 1) ≤slant frac s _ x ^ 2s _ y ^ 2 · frac σ_ 2 ^ 2σ_ 1 ^ 2 ≤slant F _ 1 - α / 2 (m - 1, n - 1)) = 1 - α ,经不等式变形即给出 σ₁²/σ₂² 的如下的 1-α 置信区间:
[ frac s _ x ^ 2s _ y ^ 2 · frac 1F _ 1 - α / 2 (m - 1 , n - 1), frac s _ x ^ 2s _ y ^ 2 · frac 1F _ α / 2 (m - 1 , n - 1) ].某车间有两台自动机床加工一类套筒,假设套筒直径服从正态分布.现在从两个班次的产品中分别检查了 5 个和 6 个套筒,得其直径 (单位: cm) 数据如下:
text 甲班: 5. 0 6 5. 0 8 5. 0 3 5. 0 0 5. 0 7text 乙班: 4. 9 8 5. 0 3 4. 9 7 4. 9 9 5. 0 2 4. 9 5试求两班加工套筒直径的方差比 σ_(甲)²/σ_(乙)² 的 0.95 置信区间.
解
此处, m=5, n=6, 若取 1-α=0.95,则查表知
l F _ 0. 0 2 5 (4, 5) = frac 1F _ 0 . 9 7 5 (5 , 4) = frac 19 . 3 6, F _ 0. 9 7 5 (4, 5) = 7. 3 9,由数据算得 s_(甲)²=0.001 07, s_(乙)²=0.000 92 ,故置信区间的两端分别为
frac s _ text 甲 ^ 2s _ text 乙 ^ 2 · frac 1F _ 0 . 9 7 5 (4 , 5) = frac 0 . 0 0 1 0 70 . 0 0 0 9 2 × frac 17 . 3 9 = 0. 1 5 7 4,frac s _ text 甲 ^ 2s _ text 乙 ^ 2 · frac 1F _ 0 . 0 2 5 (4 , 5) = frac 0 . 0 0 1 0 70 . 0 0 0 9 2 × 9. 3 6 = 1 0. 8 8 6 1,由此可知 σ_(甲)²/σ_(乙)² 的 0.95 置信区间为 [0.157 4, 10.886 1].
- 某厂生产的化纤强度服从正态分布,长期以来其标准差稳定在 σ=0.85,现抽取了一个容量为 n=25 的样本,测定其强度,算得样本均值为 barx=2.25,试求这批化纤平均强度的置信水平为 0.95 的置信区间.
- 总体 X ∼ N(μ, σ²), σ² 已知,问样本容量 n 取多大时才能保证 μ 的置信水平为 95% 的置信区间的长度不大于 k .
- 0.50, 1.25, 0.80, 2.00 是取自总体 X 的样本,已知 Y = ln X 服从正态分布 N(μ, 1) . (1) 求 μ 的置信水平为 95% 的置信区间; (2) 求 X 的数学期望的置信水平为 95% 的置信区间.
- 用一个仪表测量某一物理量9次,得样本均值 barx = 56.32 ,样本标准差 s = 0.22 . (1) 测量标准差 σ 的大小反映了测量仪表的精度,试求 σ 的置信水平为 0.95 置信区间; (2) 求该物理量真值的置信水平为 0.99 的置信区间.
- 已知某种材料的抗压强度 X ∼ N(μ, σ²) ,现随机地抽取 10 个试件进行抗压试验,测得数据如下:
(1) 求平均抗压强度 μ 的置信水平为 95% 的置信区间; (2) 若已知 σ=30 ,求平均抗压强度 μ 的置信水平为 95% 的置信区间; (3) 求 σ 的置信水平为 95% 的置信区间. 6. 在一批货物中随机抽取 80 件,发现有 11 件不合格品,试求这批货物的不合格品率的置信水平为 0.90 的置信区间. 7. 设 x₁, x₂, …, xₙ 是来自泊松分布 P(λ) 的样本,证明: λ 的近似 1 - α 置信区间为
[ frac 2 bar x + frac 1n u _ 1 - α / 2 ^ 2 - sqrt (2 bar x + frac 1n u _ 1 - α / 2 ^ 2) ^ 2 - 4 bar x ^ 22, frac 2 bar x + frac 1n u _ 1 - α / 2 ^ 2 + sqrt (2 bar x + frac 1n u _ 1 - α / 2 ^ 2) ^ 2 - 4 bar x ^ 22 ].- 某商店某种商品的月销售量服从泊松分布,为合理进货,必须了解销售情况.现记录了该商店过去的一些销售量,数据如下:
试求平均月销售量的置信水平为 0.95 的置信区间.月销售量 9 10 11 12 13 14 15 16 月份数 1 6 13 12 9 4 2 1 - 设从总体 X ∼ N(μ₁, σ₁²) 和总体 Y ∼ N(μ₂, σ₂²) 中分别抽取容量为 n₁ = 10, n₂ = 15 的独立样本,可计算得 overlinex = 82, sₓ² = 56.5, overliney = 76, s_y² = 52.4 . (1)若已知 σ₁²=64,σ₂²=49 ,求 μ₁-μ₂ 的置信水平为 95% 的置信区间; (2) 若已知 σ₁²=σ₂² ,求 μ₁-μ₂ 的置信水平为 95% 的置信区间; (3) 若对 σ₁², σ₂² 一无所知,求 μ₁-μ₂ 的置信水平为 95% 的近似置信区间; (4) 求 σ₁²/σ₂² 的置信水平为 95% 的置信区间.
- 假设人体身高服从正态分布,今抽测甲、乙两地区 18 岁~25 岁女青年身高得数据如下: 甲地区抽取 10 名,样本均值 1.64 m, 样本标准差 0.2 m; 乙地区抽取 10 名,样本均值 1.62 m, 样本标准差 0.4 m. 求: (1) 两正态总体方差比的置信水平为 95% 的置信区间; (2) 两正态总体均值差的置信水平为 95% 的置信区间.
- 设总体 X 的密度函数为 λ e⁻λ x I_({x>0}) ,其中 λ > 0 为未知参数, x₁, x₂, …, xₙ 为抽自此总体的简单随机样本,求 λ 的置信水平为 1 - α 的置信区间.
- 设某电子产品的寿命服从指数分布,其密度函数为 λ e⁻λ x I_({x>0}),现从此批产品中抽取容量为 9 的样本,测得寿命为 (单位: 千小时)
求平均寿命 1 / λ 的置信水平为0.9的置信区间和置信上、下限. 13. 设总体 X 的密度函数为
p (x; θ) = frac 1π [ 1 + (x - θ) ^ 2 ], - ∞ < x < ∞ , - ∞ < θ < ∞ ,x₁,x₂,…,xₙ 为抽自此总体的简单随机样本,求位置参数 θ 的置信水平近似为 1-α 的置信区间. 14. 设 x₁, x₂, …, xₙ 为抽自正态总体 N(μ, 16) 的简单随机样本,为使得 μ 的置信水平为 1 - α 的置信区间的长度不大于给定的 L,试问样本容量 n 至少要多少? 15. 设 x₁, x₂, …, xₙ 为抽自正态总体 N(μ, σ²) 的简单随机样本.试证:
[ bar x - (μ + k σ) ] / [ ∑_ i = 1 ^ n (x _ i - bar x) ^ 2 ] ^ 1 / 2为枢轴量,其中 k 为已知常数. 16. 设 x₁, x₂, …, xₙ 是来自 U(θ - 1/2, θ + 1/2) 的样本,求 θ 的置信水平为 1 - α 的置信区间(提示:证明 fracx_((n)) + x_((1))2 - θ 为枢轴量,并求出对应的密度函数). 17. 设 x₁, x₂, …, xₙ 为抽自均匀分布 U(θ₁, θ₂) 的简单随机样本,记 x_((1)) ≤slant x_((2)) ≤slant … ≤slant x_((n)) 为其次序统计量。求: (1) θ₂-θ₁ 的置信水平为 1-α 的置信区间; (2) (θ₂ + θ₁)/(2) 的置信水平为 1 - α 的置信区间. 18. 设 x₁, x₂, …, xₘ i.i.d. ~ U(0, θ₁), y₁, y₂, …, yₙ i.i.d ~ U(0, θ₂), θ₁ > 0, θ₂ > 0 皆未知,且两样本独立。求 fracθ₁θ₂ 的一个置信水平为 1 - α 的置信区间(提示:令 T₁ = x_((m)), T₂ = y_((n)) ,证明 fracT₂T₁ fracθ₁θ₂ 的分布与 θ₁, θ₂ 无关,并求出对应的密度函数)。 19. 设总体 X 的密度函数为
p (x, θ) = e ^ - (x - θ) I _ {x > θ }, - ∞ < θ < ∞ ,x₁,x₂,…,xₙ 为抽自此总体的简单随机样本.
(1) 证明: x_((1)) - θ 的分布与 θ 无关,并求出此分布;
(2) 求 θ 的置信水平为 1-α 的置信区间.
 统计推断的另一个主要内容是(统计)假设检验(hypothesis test).在这一章里我们将讨论(统计)假设的建立及其各种检验.
假设检验是由 K.皮尔逊 (K. Pearson) 于 20 世纪初提出的,之后由费希尔进行了细化,并最终由奈曼 (Neyman) 和 E.皮尔逊 (E. Pearson) 提出了较完整的假设检验理论.