
最大似然估计(MLE)最早是由德国数学家高斯(Gauss)在1821年针对正态分布提出的,但一般将之归功于费希尔,因为费希尔在1922年再次提出了这种想法并证明了它的一些性质而使得最大似然法得到了广泛的应用.本节将给出最大似然估计的定义与计算及求取某些复杂情况下MLE的一种有效算法——EM算法,并介绍最大似然估计的渐近正态性.
6.3.1 最大似然估计
Section titled “6.3.1 最大似然估计”为了叙述最大似然原理的直观想法,先看两个例子.
设有外形完全相同的两个箱子,甲箱中有 99 个白球和 1 个黑球,乙箱中有 99 个黑球和 1 个白球,今随机地抽取一箱,并从中随机抽取一球,结果取得白球,问这球是从哪一个箱子中取出?
解
不管是哪一个箱子,从箱子中任取一球都有两个可能的结果: A 表示“取出白球”, B 表示“取出黑球”. 如果我们取出的是甲箱,则 A 发生的概率为0.99,而如果取出的是乙箱,则 A 发生的概率为0.01. 现在一次试验中结果 A 发生了,人们的第一印象就是:“此白球 (A) 最像从甲箱取出的”,或者说,应该认为试验条件对结果 A 出现有利,从而可以推断这球是从甲箱中取出的.这个推断很符合人们的经验事实,这里“最像”就是“最大似然”之意.这种想法常称为“最大似然原理”. 本例中假设的数据很极端.一般地,我们可以这样设想:有两个箱子中各有100只球,甲箱中白球的比例是 p₁,乙箱中白球的比例是 p₂,已知 p₁>p₂,现随机地抽取一个箱子并从中抽取一球,假定取到的是白球,如果我们要在两个箱子中进行选择,由于甲箱中白球的比例高于乙箱,根据最大似然原理,我们应该推断该球来自甲箱.
设产品分为合格品与不合格品两类,我们用一个随机变量 X 来表示某个产品经检查后的不合格品数,则 X=0 表示合格品, X=1 表示不合格品,则 X 服从二点分布 b(1,p),其中 p 是未知的不合格品率.现抽取 n 个产品看其是否合格,得到样本 x₁, x₂, …, xₙ,这批观测值发生的概率为
P (X _ 1 = x _ 1, X _ 2 = x _ 2, … , X _ n = x _ n; p) = ∏_ i = 1 ^ n p ^ x _ i (1 - p) ^ 1 - x _ i = p ^ ∑_ i = 1 ^ n x _ i (1 - p) ^ n - ∑_ i = 1 ^ n x _ i, (6.3.1)由于 p 是未知的,根据最大似然原理,我们应选择 p 使得 (6.3.1) 表示的概率尽可能大.将 (6.3.1) 看作未知参数 p 的函数,用 L(p) 表示,称作似然函数,亦即
L (p) = p ^ ∑_ i = 1 ^ n x _ i (1 - p) ^ n - ∑_ i = 1 ^ n x _ i, (6.3.2)要求(6.3.2)的最大值点不是难事,将(6.3.2)两端取对数并关于p求导令其为0,即得如下方程,又称似然方程:
frac ∂ ln L (p)∂ p = frac ∑_ i = 1 ^ n x _ ip - frac n - ∑_ i = 1 ^ n x _ i1 - p = 0. (6.3.3)解之即得 p 的最大似然估计,为
hat p = hat p (x _ 1, x _ 2, … , x _ n) = ∑_ i = 1 ^ n x _ i / n = overline x.由例6.3.2 我们可以看到求最大似然估计的基本思路.对离散总体,设有样本观测值 x₁, x₂, …, xₙ,我们写出该观测值出现的概率,它一般依赖于某个或某些参数,用 θ 表示,将该概率看成 θ 的函数,用 L(θ) 表示,又称似然函数,即
L (θ) = P (X _ 1 = x _ 1, X _ 2 = x _ 2, … , X _ n = x _ n; θ),求最大似然估计就是找 θ 的估计值 hatθ = hatθ(x₁, x₂, …, xₙ) 使得上式的 L(θ) 达到最大. 对连续总体,样本观测值 x₁, x₂, …, xₙ 出现的概率总是为 0 的,但我们可用联合概率密度函数来表示随机变量在观测值附近出现的可能性大小,也将其称为似然函数,由此,我们给出如下定义.
设总体的概率函数为 p(x;θ) , θ∈Θ,其中 θ 是一个未知参数或几个未知参数组成的参数向量,Θ 是参数空间,x₁, x₂, …, xₙ 是来自该总体的样本,将样本的联合概率函数看成 θ 的函数,用 L(θ; x₁, x₂, …, xₙ) 表示,简记为 L(θ) ,
L (θ) = L (θ ; x _ 1, x _ 2, … , x _ n) = p (x _ 1; θ) p (x _ 2; θ) … p (x _ n; θ), (6.3.4)L(θ) 称为样本的似然函数.如果某统计量 hatθ = hatθ(x₁, x₂, …, xₙ) 满足
L (hat θ) = max _ θ ∈ Θ L (θ), (6.3.5)则称 hatθ 是 θ 的最大似然估计,简记为 MLE(maximum likelihood estimate). 由于 ln x 是 x 的单调增函数,因此,使对数似然函数 ln L(θ) 达到最大与使 L(θ) 达到最大是等价的.人们通常更习惯于由 ln L(θ) 出发寻找 θ 的最大似然估计.当 L(θ) 是可微函数时,求导是求最大似然估计最常用的方法,此时对对数似然函数求导更加简单些.
从最大似然估计的定义可以看出,若 L(θ) 与联合概率函数相差一个与 θ 无关的比例因子,不会影响最大似然估计,因此,可以在 L(θ) 中剔去与 θ 无关的因子.
在例6.2.6 中我们给出了 θ 的三个矩估计,这里考虑 θ 的最大似然估计.似然函数为
L (θ) = (θ^ 2) ^ n _ 1 [ 2 θ (1 - θ) ] ^ n _ 2 [ (1 - θ) ^ 2 ] ^ n _ 3 = 2 ^ n _ 2 θ^ 2 n _ 1 + n _ 2 (1 - θ) ^ 2 n _ 3 + n _ 2,其对数似然函数为
ln L (θ) = (2 n _ 1 + n _ 2) ln θ + (2 n _ 3 + n _ 2) ln (1 - θ) + n _ 2 ln 2.将之关于 θ 求导并令其为0得到似然方程
frac 2 n _ 1 + n _ 2θ - frac 2 n _ 3 + n _ 21 - θ = 0.解之,得
hat θ = frac 2 n _ 1 + n _ 22 (n _ 1 + n _ 2 + n _ 3) = frac 2 n _ 1 + n _ 22 n.由于
frac ∂^ 2 ln L (θ)∂ θ^ 2 = - frac 2 n _ 1 + n _ 2θ^ 2 - frac 2 n _ 3 + n _ 2(1 - θ) ^ 2 < 0,所以 hatθ 是极大值点.
对正态总体 N(μ, σ²), θ = (μ, σ²) 是二维参数,设有样本 x₁, x₂, …, xₙ ,则似然函数及其对数分别为
L (μ , σ^ 2) = ∏_ i = 1 ^ n (frac 1sqrt 2 π σ exp {- frac (x _ i - μ) ^ 22 σ^ 2 }) = (2 π σ^ 2) ^ - n / 2 exp {- frac 12 σ^ 2 ∑_ i = 1 ^ n (x _ i - μ) ^ 2 },ln L (μ , σ^ 2) = - frac 12 σ^ 2 ∑_ i = 1 ^ n (x _ i - μ) ^ 2 - frac n2 ln σ^ 2 - frac n2 ln (2 π),将 ln L(μ, σ²) 分别关于两个分量求偏导并令其为0即得到似然方程组
frac ∂ ln L (μ , σ^ 2)∂ μ = frac 1σ^ 2 ∑_ i = 1 ^ n (x _ i - μ) = 0, (6.3.6)frac ∂ ln L (μ , σ^ 2)∂ σ^ 2 = frac 12 σ^ 4 ∑_ i = 1 ^ n (x _ i - μ) ^ 2 - frac n2 σ^ 2 = 0.(6.3.7) 解此方程组,由(6.3.6)式可得 μ 的最大似然估计为
hat μ = frac 1n ∑_ i = 1 ^ n x _ i = overline x,将之代入(6.3.7)式给出 σ² 的最大似然估计
hat σ ^ 2 = frac 1n ∑_ i = 1 ^ n (x _ i - overline x) ^ 2 = s _ n ^ 2,利用二阶导函数矩阵的非正定性可以说明上述估计使得似然函数取极大值. 虽然求导函数是求最大似然估计最常用的方法,但并不是在所有场合求导都是有效的,下面的例子说明了这个问题.
设 x₁, x₂, …, xₙ 是来自均匀总体 U(0, θ) 的样本,试求 θ 的最大似然估计.
解
似然函数
L (θ) = frac 1θ^ n ∏_ i = 1 ^ n I _ {0 < x _ i ≤slant θ } = frac 1θ^ n I _ {x _ (n) ≤slant θ },要使 L(θ) 达到最大,首先一点是示性函数取值应该为 1 , 其次是 1 / θⁿ 尽可能大.由于 1 / θⁿ 是 θ 的单调减函数,所以 θ 的取值应尽可能小,但示性函数为 1 决定了 θ 不能小于 x_((n)),由此给出 θ 的最大似然估计 hatθ = x_((n)) . 最大似然估计有一个简单而有用的性质: 如果 hatθ 是 θ 的最大似然估计,则对任一函数 g(θ) , g(hatθ) 是其最大似然估计.该性质称为最大似然估计的不变性,从而使一些复杂结构的参数的最大似然估计的获得变得容易了.
设 x₁, x₂, …, xₙ 是来自正态总体 N(μ, σ²) 的样本,在例6.3.4 中已求得 μ 和 σ² 的最大似然估计为
hat μ = bar x, hat σ ^ 2 = s _ n ^ 2.于是由最大似然估计的不变性可得如下参数的最大似然估计,它们是 - 标准差 σ 的 MLE 是 hatσ = sₙ . - 概率 P(X < 3) = Φ((3 - μ)/(σ)) 的MLE是 Φ(frac3 - barxsₙ) . - 总体 0.90 分位数 x₀.90 = μ + σ u₀.90 的 MLE 是 overlinex + sₙ u₀.90,其中 u₀.90 为标准正态分布的 0.90 分位数.
6.3.2 EM算法
Section titled “6.3.2 EM算法”MLE 是一种非常有效的参数估计方法,但当分布中有多余参数或数据为截尾或缺失时,其 MLE 的求取是比较困难的. Dempster 等人于 1977 年提出了 EM 算法,其出发点是把求 MLE 的过程分两步走,第一步求期望,以便把多余的部分去掉,第二步求极大值.本小节将简单介绍这种非常有用的方法.
设一次试验可能有四个结果,其发生的概率分别为 1/2-(θ)/(4), (1-θ)/(4), (1+θ)/(4), (θ)/(4),其中 θ ∈ (0,1),现进行了 197 次试验,四种结果的发生次数分别为 75, 18, 70, 34. 试求 θ 的 MLE.
解
以 y₁, y₂, y₃, y₄ 表示四种结果发生的次数,此时总体分布为多项分布,故其似然函数
L (θ ; y) propto (frac 12 - frac θ4) ^ y _ 1 (frac 1 - θ4) ^ y _ 2 (frac 1 + θ4) ^ y _ 3 (frac θ4) ^ y _ 4 propto (2 - θ) ^ y _ 1 (1 - θ) ^ y _ 2 (1 + θ) ^ y _ 3 θ^ y _ 4.要由此式求解 θ 的 MLE 是比较麻烦的,由于其对数似然方程是一个三次多项式. 我们可以通过引入2个变量 z₁, z₂ 后,使得求解变得比较容易。现假设第一种结果可以分成两部分,其发生概率分别为 (1 - θ)/(4) 和 1/4 ,令 z₁ 和 y₁ - z₁ 分别表示落入这两部分的次数;再假设第三种结果分成两部分,其发生概率分别为 (θ)/(4) 和 1/4,令 z₂ 和 y₃-z₂ 分别表示落入这两部分的次数.显然,z₁,z₂ 是我们人为引入的,它是不可观测的(在文献中称之为latent variable,即潜变量).也称数据(y,z)为完全数据(complete data),而观测到的数据y称为不完全数据.此时,完全数据的似然函数
L (θ ; y, z) propto (frac 14) ^ y _ 1 - z _ 1 (frac 1 - θ4) ^ z _ 1 + y _ 2 (frac 14) ^ y _ 3 - z _ 2 (frac θ4) ^ z _ 2 + y _ 4 propto θ^ z _ 2 + y _ 4 (1 - θ) ^ z _ 1 + y _ 2,其对数似然为
l (θ ; y, z) = (z _ 2 + y _ 4) ln θ + (z _ 1 + y _ 2) ln (1 - θ).如果 (y, z) 均已知,则由上式很容易求得 θ 的 MLE,但遗憾的是,我们仅知道 y ,而不知道 z 的值。但是我们注意到,当 y 及 θ 已知时, z₁ ∼ b(y₁, (1 - θ)/(2 - θ)), z₂ ∼ b(y₃, (θ)/(1 + θ)) ,于是,Dempster 等人建议分如下两步进行迭代求解: E 步: 在已有观测数据 y 及第 i 步估计值 θ = θ^((i)) 的条件下,求基于完全数据的对数似然函数的期望 (即把其中与 z 有关的部分积分掉):
Q (θ | y, θ^ (i)) = E _ z l (θ ; y, z). (6.3.8)M 步: 求 Q(θ | y, θ^((i))) 关于 θ 的最大值 θ^((i+1)) ,即找 θ^((i+1)) 使得
Q (θ^ (i + 1) | y, θ^ (i)) = max _ θ Q (θ | y, θ^ (i)). (6.3.9)这样就完成了由 θ^((i)) 到 θ^((i + 1)) 的一次迭代.重复(6.3.8)和(6.3.9)式,直至收敛即可得到 θ 的MLE. 对于本例,其 E 步为:
r l Q (θ | y, θ^ (i)) & = (E (z _ 2 | y, θ^ (i)) + y _ 4) ln θ + (E (z _ 1 | y, θ^ (i)) + y _ 2) ln (1 - θ) & = (frac θ^ (i)1 + θ^ (i) y _ 3 + y _ 4) ln θ + (frac 1 - θ^ (i)2 - θ^ (i) y _ 1 + y _ 2) ln (1 - θ).其 M 步即为上式关于 θ 求导,并令其等于 0, 即
frac frac θ^ (i)1 + θ^ (i) y _ 3 + y _ 4θ^ (i + 1) - frac frac 1 - θ^ (i)2 - θ^ (i) y _ 1 + y _ 21 - θ^ (i + 1) = 0,解之,得如下迭代公式:
θ^ (i + 1) = frac frac θ^ (i)1 + θ^ (i) y _ 3 + y _ 4frac θ^ (i)1 + θ^ (i) y _ 3 + y _ 4 + frac 1 - θ^ (i)2 - θ^ (i) y _ 1 + y _ 2,开始时可取任意一个初值进行迭代.如取 θ^((0)) = 0.5 ,则13次迭代后可求得 θ 的MLE为0.606747,迭代过程如下表:
| 序号i | θ^((i)) | fracθ^((i))1+θ^((i))y₃+y₄ | frac1-θ^((i))2-θ^((i))y₁+y₂ | θ^((i+1)) |
| 0 | 0.5 | 57.333 333 | 43.000 000 | 0.571 429 |
| 1 | 0.571 429 | 59.454 545 | 40.500 000 | 0.594 816 |
| 2 | 0.594 816 | 60.107 784 | 39.626 214 | 0.602 681 |
| 3 | 0.602 681 | 60.323 186 | 39.325 786 | 0.605 357 |
| 4 | 0.605 357 | 60.395 987 | 39.222 803 | 0.606 271 |
| 5 | 0.606 271 | 60.420 804 | 39.187 529 | 0.606 584 |
| 6 | 0.606 584 | 60.429 289 | 39.175 449 | 0.606 691 |
| 7 | 0.606 691 | 60.432 193 | 39.171 312 | 0.606 728 |
| 8 | 0.606 728 | 60.433 187 | 39.169 896 | 0.606 740 |
| 9 | 0.606 740 | 60.433 527 | 39.169 411 | 0.606 744 |
| 10 | 0.606 744 | 60.433 644 | 39.169 245 | 0.606 746 |
| 11 | 0.606 746 | 60.433 684 | 39.169 188 | 0.606 746 |
| 12 | 0.606 746 | 60.433 697 | 39.169 168 | 0.606 747 |
| 13 | 0.606 747 | 60.433 702 | 39.169 162 | 0.606 747 |
6.3.3 渐近正态性
Section titled “6.3.3 渐近正态性”最大似然估计有一个良好的性质:它通常具有渐近正态性.
参数 θ 的相合估计 hatθₙ 称为渐近正态的,若存在趋于 0 的非负常数序列 σₙ(θ),使得 frachatθₙ-θσₙ(θ) 依分布收敛于标准正态分布.这时也称 hatθₙ 服从渐近正态分布 N(θ,σₙ²(θ)),记为 hatθₙ∼ AN(θ,σₙ²(θ)).σₙ²(θ) 称为 hatθₙ 的渐近方差. 上述定义中趋于0的数列 σₙ(θ) 表示着估计量 hatθₙ 依概率收敛于 θ 的速度.因为只有当“ σₙ(θ) 趋于 0 的速度”与“ hatθₙ 依概率收敛于 θ 的速度”相当(即同阶),其比值 (hatθₙ-θ)/σₙ(θ) 的分布才可能稳定地收敛于标准正态分布 N(0,1).倘若 σₙ(θ) 趋于 0 的速度过快,则其比值会趋于 ∞ ;倘若 σₙ(θ) 趋于 0 的速度过慢,则其比值会趋于 0;只有当 σₙ(θ) 趋于 0 的速度不快不慢时,其比值才可能按分布收敛于 N(0,1).所以 σₙ(θ) 趋于 0 的速度就是 hatθₙ 依概率收敛于 θ 的速度.故把 σₙ²(θ) 称为渐近方差是适当的.
设总体为泊松分布 P(λ) ,无论是矩估计还是最大似然估计,我们都得到一样的 λ 的估计:样本均值,即
hat λ _ n = overline x _ n = frac 1n ∑_ i = 1 ^ n x _ i.由中心极限定理, (hatλₙ - λ) / √(λ / n) 依分布收敛于 N(0,1) ,因此, hatλₙ 是渐近正态的,且
hat λ _ n ∼ A N (λ , λ / n),这里常数序列 σₙ(λ)=√(λ/n)arrow0. 它表示 hatλₙ 依概率收敛于 λ 的速度为 1/√(n) ,以后会看到,大多数渐近正态估计都是以 1/√(n) 速度依概率收敛于被估参数. 关于渐近正态性的详细的讨论超出本课程范围,我们主要指出两点:其一是不加证明地给出关于最大似然估计的渐近正态性的结论,其二说明渐近正态性常被用来对不同的相合估计进行比较,主要比较其渐近方差大小.
设总体 X 有密度函数 p(x;θ) , θ ∈ Θ , Θ 为非退化区间,假定 (1)对任意的 x ,偏导数 (∂ln p)/(∂θ),(∂²ln p)/(∂θ²) 和 (∂³ln p)/(∂θ³) 对所有 θ ∈ Θ 都存在; (2) ∀ θ ∈ Θ ,有
| frac ∂ p∂ θ | < F _ 1 (x), | frac ∂^ 2 p∂ θ^ 2 | < F _ 2 (x), | frac ∂^ 3 ln p∂ θ^ 3 | < F _ 3 (x),其中函数 F₁(x), F₂(x), F₃(x) 满足
∫_ - ∞ ^ ∞ F _ 1 (x) d x < ∞ , ∫_ - ∞ ^ ∞ F _ 2 (x) d x < ∞ ,sup _ θ ∈ Θ ∫_ - ∞ ^ ∞ F _ 3 (x) p (x; θ) d x < ∞ ;(3) ∀ θ ∈ Θ , 0 < I (θ) ≡ ∫_ - ∞ ^ ∞ (frac ∂ ln p∂ θ) ^ 2 p (x; θ) d x < ∞ .若 x₁, x₂, …, xₙ 是来自该总体的样本,则存在未知参数 θ 的最大似然估计 hatθₙ = hatθₙ(x₁, x₂, …, xₙ) ,且 hatθₙ 具有相合性和渐近正态性, hatθₙ ∼ AN(θ, (1)/(nI(θ))) . 定理6.3.1 表明,最大似然估计通常是渐近正态的,且其渐近方差 σₙ²(θ)=(nI(θ))⁻1 有一个统一的形式,其中 I(θ) 称为费希尔信息量.它的具体定义在下节给出.这里只要求按总体分布 p(x;θ) 去计算费希尔信息量和渐近方差即可.
设 x₁, x₂, …, xₙ 是来自 N(μ, σ²) 的样本,可以验证该总体分布在 σ² 已知或 μ 已知时均满足定理6.3.1 的三个条件. (1)在 σ² 已知时, μ ,由定理6.3.1知, hatμ = barx ,由定理6.3.1知, hatμ 服从渐近正态分布,下面求 I(μ) ,
ln p (x) = - ln sqrt 2 π - frac 12 ln σ^ 2 - frac (x - μ) ^ 22 σ^ 2,frac ∂ ln p∂ μ = frac x - μσ^ 2,I (μ) = E (frac x - μσ^ 2) ^ 2 = frac 1σ^ 2.从而有 hatμ∼ AN(μ,σ²/n) ,这与 μ 的精确分布相同. (2) 在 μ 已知时,σ² 的 MLE 为 hatσ²=1/n∑ᵢ=1ⁿ(xᵢ-μ)²,下求 I(σ²) ,
frac ∂ ln p∂ σ^ 2 = - frac 12 σ^ 2 + frac 12 σ^ 4 (x - μ) ^ 2 = frac (x - μ) ^ 2 - σ^ 22 σ^ 4,I (σ^ 2) = frac E [ (x - μ) ^ 2 - σ^ 2 ] ^ 24 σ^ 8 = frac Var ((x - μ) ^ 2)4 σ^ 8 = frac 12 σ^ 4,从而有 hatσ²∼ AN(σ²,2σ⁴/n) . 在有多个相合估计时,常用其渐近正态分布的方差比较好坏.
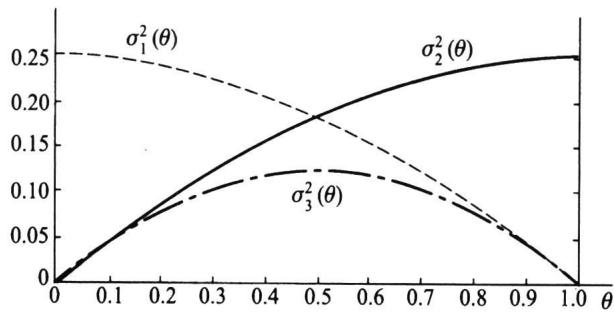
在那里我们给出 θ 的三种不同的相合估计,它们分别是:
hat θ _ 1 = sqrt n _ 1 / n, hat θ _ 2 = 1 - sqrt n _ 3 / n, hat θ _ 3 = (n _ 1 + n _ 2 / 2) / n,可以证明它们都是渐近正态估计,即
frac sqrt n (hat θ _ i - θ)σ_ i (θ) ∼ A N (0, 1), i = 1, 2, 3.诸 σᵢ²(θ) 分别为(见[15])
σ_ 1 ^ 2 (θ) = frac 1 - θ^ 24, σ_ 2 ^ 2 (θ) = frac 1 - (1 - θ) ^ 24, σ_ 3 ^ 2 (θ) = frac θ (1 - θ)2,比较三个渐近方差可以知道(见图 6.3.1),前两个估计各有优劣,而第三个估计一致好于前两个估计,而第三个估计正是最大似然估计.
- 设总体概率函数如下,x₁, x₂, …, xₙ 是样本,试求未知参数的最大似然估计. (1) p(x;θ) = √(θ) x^(√(θ) - 1),0 < x < 1,θ >0; (2) p(x;θ) = θ c^(θ)x⁻(θ +1), x > c, c > 0 已知, θ > 1 .
- 设总体概率函数如下,x₁, x₂, …, xₙ 是样本,试求未知参数的最大似然估计. (1) p(x;θ) = cθ^(c)x⁻(c + 1),x > θ ,θ >0,c > 0 已知; (2) p(x;θ ,μ) = (1)/(θ)e⁻(x - μ)/(θ),x > μ ,θ >0; (3) p(x;θ) = (kθ)⁻1,θ < x < (k + 1)θ ,θ >0,k > 0 已知.
- 设总体概率函数如下,x₁, x₂, …, xₙ 是样本,试求未知参数的最大似然估计. (1) p(x;θ) = (1)/(2θ)e⁻|x| / θ,θ >0; (2) p(x;θ) = 1, θ - 1 / 2 < x < θ + 1 / 2 ; (3) p(x; θ₁, θ₂) = (1)/(θ₂ - θ₁), θ₁ < x < θ₂.
- 一地质学家为研究密歇根湖的湖滩地区的岩石成分,随机地自该地区取 100 个样品,每个样品有 10 块石子,记录了每个样品中属石灰石的石子数.假设这 100 次观察相互独立,求这地区石子中石灰石的比例 p 的最大似然估计.该地质学家所得的数据如下:
样本中的石子数 0 1 2 3 4 5 6 7 8 9 10 样品个数 0 1 6 7 23 26 21 12 3 1 0 - 在遗传学研究中经常要从截尾二项分布中抽样,其总体概率函数为
若已知 m=2, x₁, x₂, …, xₙ 是样本,试求 p 的最大似然估计. 6. 已知在文学家萧伯纳的“The Intelligent Woman’s Guide to Socialism and Capitalism”一书中,一个句子的单词数 X 近似地服从对数正态分布,即 Z = ln X ∼ N(μ, σ²).今从该书中随机地取 20 个句子,这些句子中的单词数分别为
| 52 | 24 | 15 | 67 | 15 | 22 | 63 | 26 | 16 | 32 |
| 7 | 33 | 28 | 14 | 7 | 29 | 10 | 6 | 59 | 30 |