
5.3.1 统计量与抽样分布
Section titled “5.3.1 统计量与抽样分布”样本来自总体,因此样本中含有总体各方面的信息,但这些信息较为分散,有时显得杂乱无章.为将这些分散在样本中的有关总体的信息集中起来以反映总体的各种特征,需要对样本进行加工,表和图是一类加工形式,它使人们从中获得对总体的初步认识.当人们需要从样本获得对总体各种参数的认识时,更有效的加工方法是构造样本的函数,不同的样本函数反映总体的不同特征.
设 x₁, x₂, …, xₙ 为取自某总体的样本,若样本函数 T = T(x₁, x₂, …, xₙ) 中不含有任何未知参数,则称 T 为统计量。统计量的分布称为抽样分布。 按照这一定义,若 x₁, x₂, …, xₙ 为样本,则 ∑ᵢ=1ⁿ xᵢ, ∑ᵢ=1ⁿ xᵢ² 以及 5.2.1 节中的 Fₙ(x) 都是统计量.而当 μ, σ² 未知时,x₁ - μ, x₁ / σ 等均不是统计量.必须指出的是: 尽管统计量不依赖于未知参数,但是它的分布是依赖于未知参数的. 下面几小节及 5.4 节我们介绍一些常见的统计量及其抽样分布.
5.3.2 样本均值及其抽样分布
Section titled “5.3.2 样本均值及其抽样分布”设 x₁, x₂, …, xₙ 为取自某总体的样本,其算术平均值称为样本均值,一般用 barx 表示,即
overline x = frac x _ 1 + x _ 2 + … + x _ nn = frac 1n ∑_ i = 1 ^ n x _ i. (5.3.1)在分组样本场合,样本均值的近似公式为
overline x = frac x _ 1 f _ 1 + x _ 2 f _ 2 + … + x _ k f _ kn (n = ∑_ i = 1 ^ k f _ i). (5.3.2)其中 k 为组数,xᵢ 为第 i 组的组中值,fᵢ 为第 i 组的频数.
某单位收集到20名青年人某月的娱乐支出费用数据:
c c c c c c c c c c 7 9 0 & 8 4 0 & 8 4 0 & 8 8 0 & 9 2 0 & 9 3 0 & 9 4 0 & 9 7 0 & 9 8 0 & 9 9 0 1 0 0 0 & 1 0 1 0 & 1 0 1 0 & 1 0 2 0 & 1 0 2 0 & 1 0 8 0 & 1 1 0 0 & 1 1 3 0 & 1 1 8 0 & 1 2 5 0则该月这20名青年的平均娱乐支出为
overline x = frac 12 0 (7 9 0 + 8 4 0 + … + 1 2 5 0) = 9 9 4.将这 20 个数据分组可得到如下频数频率表: 表 5.3.1 例5.3.1 的频数频率分布表
| 组序 | 分组区间 | 组中值 | 频数 | 频率(%) |
| 1 | (770,870] | 820 | 3 | 15 |
| 2 | (870,970] | 920 | 5 | 25 |
| 3 | (970,1070] | 1020 | 7 | 35 |
| 4 | (1070,1170] | 1120 | 3 | 15 |
| 5 | (1170,1270] | 1220 | 2 | 10 |
| 合计 | 20 | 100 |
我们看到两种计算结果不同.事实上,由于(5.3.2)式未用到真实的样本观测数据,因而给出的是近似结果. 关于样本均值,有如下几个性质.
若把样本中的数据与样本均值之差称为偏差,则样本所有偏差之和为 0 , 即 ∑ᵢ=1ⁿ(xᵢ-barx)=0 . 从均值的计算公式看,它使用了所有的数据,而且每一个数据在计算公式中处于平等的地位.所有数据与样本中心 barx 的偏差可正可负,且被互相抵消,从而样本的所有偏差之和必为零.
数据观测值与样本均值的偏差平方和最小,即在形如 ∑ (xᵢ - c)² 的函 数中, ∑ (xᵢ - overlinex)² 最小,其中 c 为任意给定常数
证明
对任意给定的常数 c
r l ∑ (x _ i - c) ^ 2 & = ∑ (x _ i - overline x + overline x - c) ^ 2 & = ∑ (x _ i - overline x) ^ 2 + n (overline x - c) ^ 2 + 2 ∑ (x _ i - overline x) (overline x - c) & = ∑ (x _ i - overline x) ^ 2 + n (overline x - c) ^ 2 ≥slant ∑ (x _ i - overline x) ^ 2.下面考察样本均值的分布.
| 11 | 8 | 样本1 | 样本2 | 样本3 | 样本4 | |
| 12 | 13 | → | 11 | 8 | 13 | 12 |
| 8 | 9 | |||||
| 11 | 10 | → | 11 | 13 | 11 | 9 |
| 9 | 11 | |||||
| 10 | 8 | → | 9 | 10 | 11 | 10 |
| 10 | 12 | → | 10 | 11 | 10 | 10 |
| 11 | 9 | |||||
| 8 | 11 | → | 8 | 9 | 9 | 11 |
| 10 | 13 | 样本均值 | 9.8 | 10.2 | 10.8 | 10.4 |
设有一个由 20 个数组成的总体,现从该总体同时取出容量为 5 的样本.图 5.3.1 画出第一个样本的抽样过程,左侧是该总体,右侧是从总体中随机地抽出的样本,记录后,放回,再抽第二个样本.这里一共抽出 4 个样本,每个样本有 5 个观测值,我们计算了各个样本的样本均值.由抽样的随机性,每一个样本的样本均值都有差别.
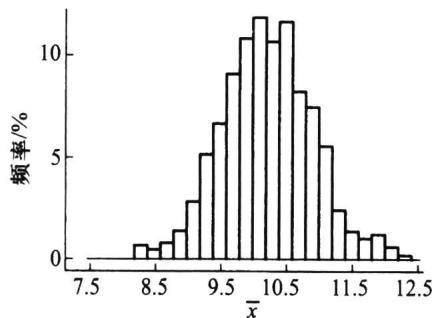
设想类似抽取样本 5、样本 6……每次都计算样本均值 barx 的值,图 5.3.2 就是用这样得到的 500 个 barx 的值,图 5.3.2 就是用这样得到的 500 个 barx
它的外形很像正态分布,这不是偶然的,有下面定理保证.
图 5.3.2 500个样本均值形成的直方图barx 的抽样分布。
 它的外形很像正态分布,这不是偶然的,有下面定理保证.
图5.3.2 500个样本均值形成的直方图
设 x₁, x₂, …, xₙ 是来自某个总体的样本, barx 为样本均值. (1) 若总体分布为 N(μ, σ²) ,则 barx 的精确分布为 N(μ, σ²/n) ; (2)若总体分布未知或不是正态分布, E(x)=μ,operatornameVar(x)=σ² 存在,则 n 较大时 barx 的渐近分布为 N(μ,σ²/n) ,常记为 barx∼ N(μ,σ²/n) 。这里渐近分布是指 n 较大时的近似分布。
证明
(1)利用卷积公式,可得知 ∑ᵢ=1ⁿxᵢ∼ N(nμ,nσ²),由此可知 barx∼ N(μ,σ²/n) . (2)由中心极限定理, √(n) (barx - μ) / σ xrightarrowL N(0,1) ,这表明 n 较大时 barx 的渐近分布为 N(μ, σ² / n) ,证明完成.
图 5.3.3 给出三个不同总体样本均值的分布密度函数.三个总体分别是: ① 均匀分布 ② 倒三角分布 ③ 指数分布,随着样本量的增加,样本均值 barx 的抽样分布逐渐向正态分布逼近,它们的均值保持不变,而方差则缩小为原来的 1/n.当样本量为 30 时,我们看到三个抽样分布都近似于正态分布.下面对之进行具体说明.
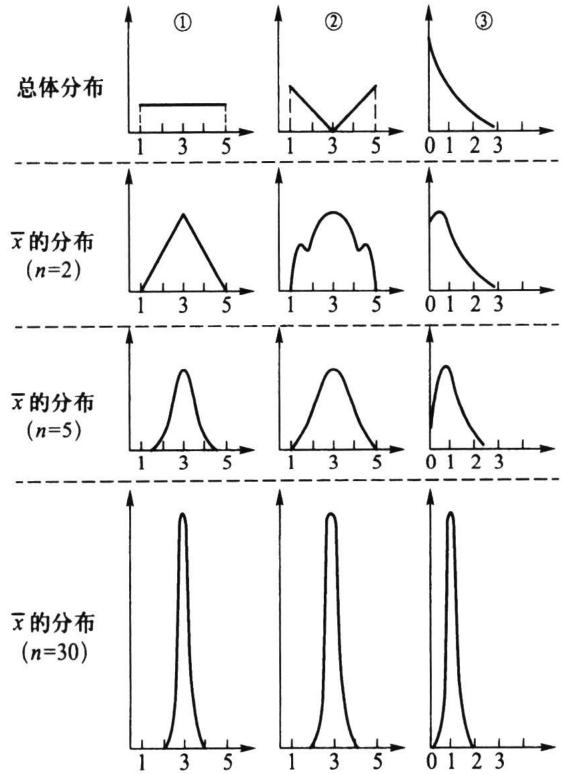
① 的总体分布为均匀分布 U(1,5) ,该总体的均值和方差分别为3和4/3,若从该总体抽取样本容量为30的样本,则其样本均值的渐近分布为
overline x _ 1 dot ∼ N (3, frac 43 × 3 0) = N (3, 0. 2 1 ^ 2).② 的总体分布的概率密度函数为
p (x) = { l l (3 - x) / 4, & 1 ≤slant x < 3, (x - 3) / 4, & 3 ≤slant x ≤slant 5, 0, & text 其他. .这是一个倒三角分布,可以算得其均值与方差分别为3和2,若从该总体抽取样本容量为30的样本,则其样本均值的渐近分布为
overline x _ 2 ∼ N (3, frac 23 0) = N (3, 0. 2 6 ^ 2).③ 的总体分布为指数分布 Exp(1),其均值与方差都等于 1, 若从该总体抽取样本容量为 30 的样本,则其样本均值 overlinex₃ 的分布近似为
overline x _ 3 dot ∼ N (1, frac 13 0) = N (1, 0. 1 8 ^ 2).这三个总体都不是正态分布,但其样本均值的分布都近似于正态分布,差别表现 在均值与标准差上.图 5.3.3 所示曲线既展示它们的共同之处,又显示它们之间的差别.
5.3.3 样本方差与样本标准差
Section titled “5.3.3 样本方差与样本标准差”设 x₁, x₂, …, xₙ 为取自某总体的样本,则它关于样本均值 barx 的平均偏差平方和
s _ n ^ 2 = frac 1n ∑_ i = 1 ^ n (x _ i - bar x) ^ 2 (5.3.3)称为样本方差.其算术根 sₙ=sqrtsₙ² 称为样本标准差.相对样本方差而言,样本标准差通常更有实际意义,因为它与样本均值具有相同的度量单位.在n不大时,常用
s ^ 2 = frac 1n - 1 ∑_ i = 1 ^ n (x _ i - overline x) ^ 2 (5.3.4)作为样本方差(也称无偏方差,其含义在第六章讲述),其算术根 s=sqrts² 也称为样本标准差.在实际中,s² 比 sₙ² 更常用,在以后讲样本方差通常指的是 s² . 样本方差 (s² 或 sₙ²) 是度量样本散布大小的统计量,使用广泛,在它的这个定义中,n 为样本量,∑ᵢ=1ⁿ(xᵢ-barx)² 称为偏差平方和, n-1 称为偏差平方和的自由度.其含义是: 在 barx 确定后,n 个偏差 x₁-barx, x₂-barx, …, xₙ-barx 中只有 n-1 个偏差可以自由变动,而第 n 个则不能自由取值,因为 ∑(xᵢ-barx)=0 . 样本偏差平方和有三个常用的表达式:
∑ (x _ i - overline x) ^ 2 = ∑ x _ i ^ 2 - frac (∑ x _ i) ^ 2n = ∑ x _ i ^ 2 - n overline x ^ 2. (5.3.5)它们都可用来计算样本方差. 在分组样本场合,样本方差的近似计算公式为
s ^ 2 = frac 1n - 1 ∑_ i = 1 ^ k f _ i (x _ i - overline x) ^ 2 = frac 1n - 1 (∑_ i = 1 ^ k f _ i x _ i ^ 2 - n overline x ^ 2), (5.3.6)其中 xᵢ, fᵢ 分别为第 i 个区间的组中值和频数, overlinex 为(5.3.2)式给出的样本均值近似值.
考察例5.3.1 的样本,我们已经算得 barx=994,其样本方差与样本标准差分别为
r l & s ^ 2 = frac 12 0 - 1 [ (7 9 0 - 9 9 4) ^ 2 + (8 4 0 - 9 9 4) ^ 2 + … + (1 2 5 0 - 9 9 4) ^ 2 ] = 1 3 3 9 3. 6 8, & s = sqrt 1 3 3 9 3 . 6 8 = 1 1 5. 7 3 1,对表 5.3.1 的分组样本,我们可以如表 5.3.2 计算(样本均值也由分组样本计算): 表 5.3.2 分组样本方差的计算表
| 组中值x | 频数f | xf | x-overlinex | (x-overlinex)²f |
| 820 | 3 | 2 460 | -180 | 97 200 |
| 920 | 5 | 4 600 | -80 | 32 000 |
| 1 020 | 7 | 7 140 | 20 | 2 800 |
| 组中值x | 频数f | xf | x-overlinex | (x-overlinex)²f |
| 1 120 | 3 | 3 360 | 120 | 43 200 |
| 1 220 | 2 | 2 440 | 220 | 96 800 |
| 和 | 20 | 20 000 | 272 000 |
设总体 X 具有二阶矩,即 E(X)=μ , Var(X)=σ²<∞ , x₁, x₂, …, xₙ 为从该总体得到的样本,barx 和 s² 分别是样本均值和样本方差,则
E (overline x) = μ , operatornameVar (overline x) = σ^ 2 / n, (5.3.7)E (s ^ 2) = σ^ 2. (5.3.8)此定理表明,样本均值的期望与总体均值相同,而样本均值的方差是总体方差的 1/n.
证明
由于
E (overline x) = frac 1n E (∑_ i = 1 ^ n x _ i) = frac n μn = μ ,operatornameVar (bar x) = frac 1n ^ 2 operatornameVar (∑_ i = 1 ^ n x _ i) = frac n σ^ 2n ^ 2 = frac σ^ 2n,故(5.3.7)式成立.下证(5.3.8)式,注意到
∑_ i = 1 ^ n (x _ i - overline x) ^ 2 = ∑_ i = 1 ^ n x _ i ^ 2 - n overline x ^ 2,而 E(xᵢ²) = (E(xᵢ))² + Var(xᵢ) = μ² + σ², E(overlinex²) = (E(overlinex))² + Var(overlinex) = μ² + σ² / n ,于是
E (∑_ i = 1 ^ n (x _ i - bar x) ^ 2) = n (μ^ 2 + σ^ 2) - n (μ^ 2 + σ^ 2 / n) = (n - 1) σ^ 2,两边各除以 n-1,即得(5.3.8)式.
5.3.4 样本矩及其函数
Section titled “5.3.4 样本矩及其函数”样本均值和样本方差的更一般的推广是样本矩,这是一类常见的统计量.
设 x₁, x₂, …, xₙ 是样本,k 为正整数,则统计量
a _ k = frac 1n ∑_ i = 1 ^ n x _ i ^ k (5.3.9)称为样本 k 阶原点矩,特别,样本一阶原点矩就是样本均值.统计量
b _ k = frac 1n ∑_ i = 1 ^ n (x _ i - overline x) ^ k (5.3.10)称为样本 k 阶中心矩.特别,样本二阶中心矩就是样本方差. 当总体关于分布中心对称时,我们用 barx 和 s 刻画样本特征很有代表性,而当其不对称时,只用 barx, s 就显得很不够.为此,需要一些刻画分布形状的统计量(参见 §2.7.5 和 §2.7.6).这里我们介绍样本偏度和样本峰度,它们都是样本中心矩的函数.
设 x₁, x₂, …, xₙ 是样本,则称统计量
hat β _ s = b _ 3 / b _ 2 ^ 3 / 2 (5.3.11)为样本偏度.
样本偏度 hatβₛ 反映了样本数据与对称性的偏离程度和偏离方向.如果数据完全对称,则不难看出 b₃ = 0.对不对称的数据则 b₃ ≠ 0.这里用 b₃ 除以 b₂³/2 是为了消除量纲的影响,hatβₛ 是个相对数,它很好地刻画了数据分布的偏斜方向和程度.如果 hatβₛ = 0,表示样本对称 (见图 5.3.4(a 明显大于0, 表示样本的右尾长,即样本中有几个较大的数,这反映总体分布是正偏的或右偏的 (见图 5.3.4(hatβₛ 明显小于0, 表示分布的左尾长,即样本中有几个特小的数,这反映总体分布是负偏的或左偏的 (见图 5.3.4(b)); 如果 hatβₛ 明显小于0, 表示分布的左尾长,即样本中有几个特小的数,这反映总体分布是负偏的或左偏的 (见图5.3.4(c)).
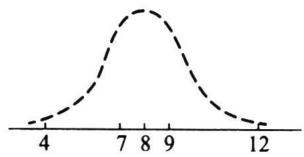
(a) 样本 (4, 7, 8, 9, 12) 的偏度 hatβ_(S)=0
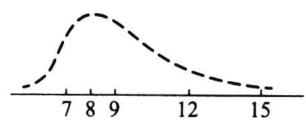
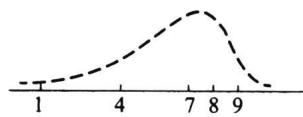 图 5.3.4 样本偏度
(c) 样本 (1, 4, 7, 8, 9) 的偏度 hatβ_(S)=-0.5692
图 5.3.4 样本偏度 hatβₛ 的例子(样本量 n=5)
设 x₁, x₂, …, xₙ 是样本,则称统计量
hat β _ k = frac b _ 4b _ 2 ^ 2 - 3 (5.3.12)为样本峰度. 样本峰度 hatβₖ 是反映总体分布密度曲线在其峰值附近的陡峭程度和尾部粗细的统计量.当 hatβₖ 明显大于 0 时,分布密度曲线在其峰值附近比正态分布来得陡,尾部更细,称为尖顶型; 当 hatβₖ 明显小于 0 时,分布密度曲线在其峰值附近比正态分布来得平坦,尾部更粗,称为平顶型.
表 5.3.3 是两个班(每班 50 名同学)的英语课程的考试成绩. 表 5.3.3 两个班级的英语成绩
| 成绩 | 组中值 | 甲班人数 f_(甲) | 乙班人数 f_(乙) |
| 90~100 | 95 | 5 | 4 |
| 80~89 | 85 | 10 | 14 |
| 70~79 | 75 | 22 | 16 |
| 60~69 | 65 | 11 | 14 |
| 50~59 | 55 | 1 | 2 |
| 40~49 | 45 | 1 | 0 |
| x | f_(甲) | x · f_(甲) | (x-overlinex_(甲))²f_(甲) | (x-overlinex_(甲))³f_(甲) | (x-overlinex_(甲))⁴f_(甲) |
| 95 | 5 | 475 | 1 843.20 | 35 389.440 | 679 477.248 0 |
| 85 | 10 | 850 | 846.40 | 7 786.880 | 71 639.296 0 |
| 75 | 22 | 1 650 | 14.08 | -11.264 | 9.011 2 |
| 65 | 11 | 715 | 1 283.04 | -13 856.832 | 149 653.785 6 |
| 55 | 1 | 55 | 432.64 | -8 998.912 | 187 177.369 6 |
| 45 | 1 | 45 | 948.64 | -29 218.112 | 899 917.849 6 |
| 和 | 50 | 3 790 | 5 368 | -8 908.8 | 1 987 874.56 |
| x | f_(乙) | x · f_(乙) | (x-overlinex_(乙))²f_(乙) | (x-overlinex_(乙))³f_(乙) | (x-overlinex_(乙))⁴f_(乙) |
| 95 | 4 | 380 | 1 474.56 | 28 311.552 | 543 581.798 4 |
| 85 | 14 | 1 190 | 1 184.96 | 10 901.632 | 100 295.014 4 |
| 75 | 16 | 1 200 | 10.24 | -8.192 | 6.553 6 |
| 65 | 14 | 910 | 1 632.96 | -17 635.968 | 190 468.454 4 |
| 55 | 2 | 110 | 865.28 | -17 997.824 | 374 354.739 2 |
| 和 | 50 | 3 790 | 5 168 | 3 571.2 | 1 208 706.56 |
由此可见,两个班级的平均成绩相同,标准差也几乎相同,样本偏度分别为-0.16和0.068,显示两个班的成绩都是基本对称的.但两个班的样本峰度明显不同.乙班的成绩分布比较平坦,而甲班则稍显尖顶.
5.3.5 次序统计量及其分布
Section titled “5.3.5 次序统计量及其分布”除了样本矩以外,另一类常见的统计量是次序统计量,它在实际和理论中都有广泛的应用.
设 x₁, x₂, …, xₙ 是取自总体 X 的样本, x_((i)) 称为该样本的第 i 个次序统计量,它的取值是将样本观测值由小到大排列后得到的第 i 个观测值。其中 x_((1)) = min{x₁, x₂, …, xₙ} 称为该样本的最小次序统计量, x_((n)) = max{x₁, x₂, …, xₙ} 称为该样本的最大次序统计量.(x_((1)),x_((2)),…,x_((n))) 称为该样本的次序统计量. 我们知道,在一个(简单随机)样本中,x₁,x₂,…,xₙ 是独立同分布的,而次序统计量 x_((1)),x_((2)),…,x_((n)) 则既不独立,分布也不相同,看下例.
设总体 X 的分布为仅取 0,1,2 的离散均匀分布,分布列为
| x | 0 | 1 | 2 |
| p | 1/3 | 1/3 | 1/3 |
| x₁ | x₂ | x₃ | x_((1)) | x_((2)) | x_((3)) | x₁ | x₂ | x₃ | x_((1)) | x_((2)) | x_((3)) |
| 0 | 0 | 0 | 0 | 0 | 0 | 1 | 2 | 0 | 0 | 1 | 2 |
| 0 | 0 | 1 | 0 | 0 | 1 | 2 | 1 | 0 | 0 | 1 | 2 |
| 0 | 1 | 0 | 0 | 0 | 1 | 0 | 2 | 2 | 0 | 2 | 2 |
| 1 | 0 | 0 | 0 | 0 | 1 | 2 | 0 | 2 | 0 | 2 | 2 |
| 0 | 0 | 2 | 0 | 0 | 2 | 2 | 2 | 0 | 0 | 2 | 2 |
| 0 | 2 | 0 | 0 | 0 | 2 | 1 | 1 | 2 | 1 | 1 | 2 |
| 2 | 0 | 0 | 0 | 0 | 2 | 1 | 2 | 1 | 1 | 1 | 2 |
| 0 | 1 | 1 | 0 | 1 | 1 | 2 | 1 | 1 | 1 | 1 | 2 |
| 1 | 0 | 1 | 0 | 1 | 1 | 1 | 2 | 2 | 1 | 2 | 2 |
| 1 | 1 | 0 | 0 | 1 | 1 | 2 | 1 | 2 | 1 | 2 | 2 |
| 0 | 1 | 2 | 0 | 1 | 2 | 2 | 2 | 1 | 1 | 2 | 2 |
| 0 | 2 | 1 | 0 | 1 | 2 | 1 | 1 | 1 | 1 | 1 | 1 |
| 1 | 0 | 2 | 0 | 1 | 2 | 2 | 2 | 2 | 2 | 2 | 2 |
| 2 | 0 | 1 | 0 | 1 | 2 |
| x_((1)) | 0 | 1 | 2 |
| p | (19)/(27) | (7)/(27) | (1)/(27) |
| x_((1)) | x_((2)) | ||
| 0 | 1 | 2 | |
| 0 | 7/27 | 9/27 | 3/27 |
| 1 | 0 | 4/27 | 3/27 |
| 2 | 0 | 0 | 1/27 |
二、单个次序统计量的分布
Section titled “二、单个次序统计量的分布”设总体 X 的密度函数为 p(x) ,分布函数为 F(x) , x₁ , x₂ , … , xₙ 为样本,则第 k 个次序统计量 x_((k)) 的密度函数为
p _ k (x) = frac n !(k - 1) ! (n - k) ! (F (x)) ^ k - 1 (1 - F (x)) ^ n - k p (x). (5.3.13)证明
对任意的实数 x ,考虑次序统计量 x_((k)) 取值落在小区间 (x, x + Δ x] 内这一事件,它等价于“样本容量为 n 的样本中有 1 个观测值落在 (x, x + Δ x] 之间(多于一个观测值落在区间 (x, x + Δ x] 的概率是 Δ x 的高阶无穷小量,后同),而有 k - 1 个观测值小于等于 x ,有 n - k 个观测值大于 x + Δ x ”,其直观示意见图 5.3.5.
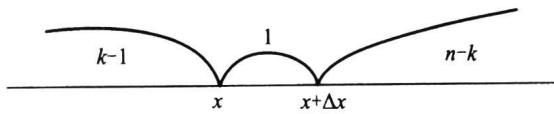
样本的每一个分量小于等于 x 的概率为 F(x),落入区间 (x, x + Δ x] 的概率为 F(x + Δ x) - F(x),大于 x + Δ x 的概率为 1 - F(x + Δ x),而将 n 个分量分成这样的三组,总的分法有 (n!)/((k-1)!1!(n-k)!) 种.于是,若以 Fₖ(x) 记 x_((k)) 的分布函数,则由多项分布可得
r l F _ k (x + Δ x) - F _ k (x) & ≈ frac n !(k - 1) ! (n - k) ! (F (x)) ^ k - 1 (F (x + Δ x) - & F (x)) (1 - F (x + Δ x)) ^ n - k,两边除以 Δ x ,并令 Δ x→ 0 ,即有
r l p _ k (x) & = lim _ Δ x → 0 frac F _ k (x + Δ x) - F _ k (x)Δ x & = frac n !(k - 1) ! (n - k) ! (F (x)) ^ k - 1 p (x) (1 - F (x)) ^ n - k,其中 pₖ(x) 的非零区间与总体的非零区间相同.特别,令 k = 1 和 k = n 即得到最小次序统计量 x_((1)) 和最大次序统计量 x_((n)) 的密度函数分别为
p _ 1 (x) = n · (1 - F (x)) ^ n - 1 p (x), (5.3.14)p _ n (x) = n · (F (x)) ^ n - 1 p (x). (5.3.15)设总体密度函数为
p (x) = 3 x ^ 2, 0 < x < 1,现从该总体抽得一个容量为 5 的样本,试计算 P(x_((2))<1/2) .
解
我们首先应求出 x_((2)) 的分布.由总体密度函数不难求出总体分布函数为
F (x) = { l l 0, & x ≤slant 0, x ^ 3, & 0 < x < 1, 1, & x ≥slant 1. .由公式(5.3.13)可以得到 x_((2)) 的密度函数为
r l p _ 2 (x) & = frac 5 !(2 - 1) ! (5 - 2) ! (F (x)) ^ 2 - 1 p (x) (1 - F (x)) ^ 5 - 2 & = 2 0 · x ^ 3 · 3 x ^ 2 · (1 - x ^ 3) ^ 3 & = 6 0 x ^ 5 (1 - x ^ 3) ^ 3, 0 < x < 1,于是
r l P (x _ (2) < 1 / 2) & = ∫_ 0 ^ 1 / 2 6 0 x ^ 5 (1 - x ^ 3) ^ 3 d x & = ∫_ 0 ^ 1 / 8 2 0 y (1 - y) ^ 3 d y = ∫_ 7 / 8 ^ 1 2 0 (z ^ 3 - z ^ 4) d z & = 5 (1 - (frac 78) ^ 4) - 4 (1 - (frac 78) ^ 5) = 0. 1 2 0 7.设总体分布为 U(0,1) , x₁ , x₂ , … , xₙ 为样本,则其第 k 个次序统计量的密度函数为
p _ k (x) = frac n !(k - 1) ! (n - k) ! x ^ k - 1 (1 - x) ^ n - k, 0 < x < 1,这就是 §2.5 中介绍的贝塔分布 Be(k, n-k+1) ,从而有 E(x_((k))) = (k)/(n+1) .
三、多个次序统计量及其函数的分布
Section titled “三、多个次序统计量及其函数的分布”下面我们讨论任意两个次序统计量的联合分布.对三个或三个以上次序统计量的分布可参照进行.
在定理5.3.3 的记号下,次序统计量 (x_((i)), x_((j))) (i<j) 的联合分布密度函数为
r l p _ i j (y, z) & = frac n !(i - 1) ! (j - i - 1) ! (n - j) ! [ F (y) ] ^ i - 1 [ F (z) - F (y) ] ^ j - i - 1. & [ 1 - F (z) ] ^ n - j p (y) p (z), y ≤slant z, (5.3.16)证明
对增量 Δ y, Δ z 以及 y < z,事件 {x_((i)) ∈ (y, y + Δ y], x_((j)) ∈ (z, z + Δ z]} 可以表述为“容量为 n 的样本 x₁, x₂, …, xₙ 中有 i - 1 个观测值小于等于 y,一个落入区间 (y, y + Δ y], j - i - 1 个落入区间 (y + Δ y, z] ,一个落入区间 (z, z + Δ z] ,而余下 n - j 个大于 z + Δ z ”(见图 5.3.6). 于是由多项分布可得
r l & P (x _ (i) ∈ (y, y + Δ y), x _ (j) ∈ (z, z + Δ z)) & ≈ frac n !(i - 1) ! 1 ! (j - i - 1) ! 1 ! (n - j) ! [ F (y) ] ^ i - 1 p (y) Δ y [ F (z) - & F (y + Δ y) ] ^ j - i - 1 p (z) Δ z [ 1 - F (z + Δ z) ] ^ n - j,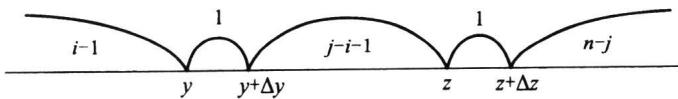
考虑到 F(x) 的连续性,当 Δ y→ 0,Δ z→ 0 时有 F(y + Δ y)arrow F(y),F(z + Δ z)arrow F(z) ,于是
r l p _ i j (y, z) & = lim _ Δ y → 0, Δ z → 0 frac P (x _ (i) ∈ (y , y + Δ y) , x _ (j) ∈ (z , z + Δ z))Δ y · Δ z & = frac n !(i - 1) ! (j - i - 1) ! (n - j) ! [ F (y) ] ^ i - 1 [ F (z) - & F (y) ] ^ j - i - 1 [ 1 - F (z) ] ^ n - j p (y) p (z).定理得证. 在实际问题中会用到一些次序统计量的函数,如: Rₙ = x_((n)) - x_((1)) 称为样本极差,是一个很常用的统计量,要推导这个统计量的分布原则上并不难,我们只要使用定理5.3.4 以及第三章讲过的随机变量函数的分布求法即可解决.但它们的分布常用积分表示,只在很少几种场合可用初等函数表示,下面是一个样本极差的分布可用初等函数表示的例子.
设总体分布为 U(0,1) , x₁ , x₂ , … , xₙ 为其样本,则 (Y,Z)=(x_((1)),x_((n))) 的联合密度函数为
p (y, z) = n (n - 1) (z - y) ^ n - 2, 0 < y < z < 1.令 R=Z-Y,由 R>0,0<Y<Z<1,可以推出 0<Y=Z-R≤slant1-R ,则 (Y,R) 的联合分布密度为 p(y,r)=n(n-1)rⁿ-2, y>0,r>0,y+r<1, 于是 R 的边际密度函数为
p _ R (r) = ∫_ 0 ^ 1 - r n (n - 1) r ^ n - 2 d y = n (n - 1) r ^ n - 2 (1 - r), 0 < r < 1,这正是参数为 (n - 1,2) 的贝塔分布.
5.3.6 样本分位数与样本中位数
Section titled “5.3.6 样本分位数与样本中位数”样本中位数 m₀.5 也是一个很常见的统计量,它也是次序统计量的函数,通常如下定义:
m _ 0. 5 = { l l x (frac n + 12) & , n text 为奇数, frac 12 (x (frac n2) + x (frac n2 + 1)), & n text 为偶数. .譬如,若 n = 5 ,则 m₀.5 = x_((3)) ,若 n = 6 ,则 m₀.5 = 1/2 (x_((3)) + x_((4))) 更一般地,样本 p 分位数 mₚ 可如下定义:
m _ p = { l l x _ ([ n p + 1 ]), & text 若 n p text 不是整数, frac 12 (x _ (n p) + x _ (n p + 1)), & text 若 n p text 是整数. .譬如,若 n = 10, p = 0.35 ,则 m₀.35 = x_((4)) ,若 n = 20, p = 0.45 ,则 m₀.45 = 1/2(x_((9)) + x_((10))) 对多数总体而言,要给出样本 p 分位数的精确分布通常不是一件容易的事.幸运的是当 n → ∞ 时样本 p 分位数的渐近分布有比较简单的表达式,我们这里不加证明地给出如下定理.
设总体密度函数为 p(x) , xₚ 为其 p 分位数,p(x) 在 xₚ 处连续且 p(xₚ) > 0,则当 n → ∞ 时样本 p 分位数 mₚ 的渐近分布为
m _ p dot ∼ N (x _ p, frac p (1 - p)n · p ^ 2 (x _ p)). (5.3.17)特别,对样本中位数,当 n → ∞ 时近似地有
m _ 0. 5 dot ∼ N (x _ 0. 5, frac 14 n · p ^ 2 (x _ 0 . 5)). (5.3.18)设总体为柯西分布,密度函数为
p (x; θ) = frac 1π (1 + (x - θ)) ^ 2, - ∞ < x < ∞ ,其分布函数为
F (x; θ) = frac 12 + frac 1π arctan (x - θ).不难看出 θ 是该总体的中位数,即 x₀.5=θ.设 x₁, x₂, …, xₙ 是来自该总体的样本,当样本量 n 较大时,样本中位数 m₀.5 的渐近分布为
m _ 0. 5 ∼ N (θ , frac π^ 24 n).通常,样本均值在概括数据方面具有一定的优势.但样本均值也有其不足之处.设我们有5个数3,5,9,10,13,则其均值为 (3+5+9+10+13)/5=8.如果我们不小心将13错输入为133(比如在计算机输入时将3连按2下),则均值即变为 (3+5+9+10+133)/5=32.这说明均值受极端数值影响较大,与之相对应,中位数则不受极端值的影响,因此,当数据中含有极端值时,使用中位数比使用均值更好,中位数的这种抗干扰性在统计中称为具有稳健性.
5.3.7 五数概括与箱线图
Section titled “5.3.7 五数概括与箱线图”次序统计量的应用之一是五数概括与箱线图.在得到有序样本后,容易计算如下五个值:最小观测值 x_(min)=x_((1)),最大观测值 x_(max)=x_((n)),中位数 m₀.5,第一4分位数 Q₁=m₀.25 和第三4分位数 Q₃=m₀.75.所谓五数概括就是指用这五个数
x _ min, Q _ 1, m _ 0. 5, Q _ 3, x _ max来大致描述一批数据的轮廓.
表 5.3.7 是某厂 160 名销售人员某月的销售量数据的有序样本,由该批数据可计算得到: x_(min)=45, x_(max)=319, m₀.5=181, Q₁=144, Q₃=212 . 表 5.3.7 某厂 160 名销售员的月销售量的有序样本
| 45 | 74 | 76 | 80 | 87 | 91 | 92 | 93 | 95 | 96 |
| 98 | 99 | 104 | 106 | 111 | 113 | 117 | 120 | 122 | 122 |
| 124 | 126 | 127 | 127 | 129 | 129 | 130 | 131 | 131 | 133 |
| 134 | 134 | 135 | 136 | 137 | 137 | 139 | 141 | 141 | 143 |
| 145 | 148 | 149 | 149 | 149 | 150 | 150 | 153 | 153 | 153 |
| 153 | 154 | 157 | 160 | 160 | 162 | 163 | 163 | 165 | 165 |
| 167 | 167 | 168 | 170 | 171 | 172 | 173 | 174 | 175 | 175 |
| 176 | 178 | 178 | 178 | 179 | 179 | 179 | 180 | 181 | 181 |
| 181 | 182 | 182 | 185 | 185 | 186 | 186 | 187 | 188 | 188 |
| 188 | 189 | 189 | 191 | 191 | 191 | 192 | 192 | 194 | 194 |
| 194 | 194 | 195 | 196 | 197 | 197 | 198 | 198 | 198 | 199 |
| 200 | 201 | 202 | 204 | 204 | 205 | 205 | 206 | 207 | 210 |
| 214 | 214 | 215 | 215 | 216 | 217 | 218 | 219 | 219 | 221 |
| 221 | 221 | 221 | 221 | 222 | 223 | 223 | 224 | 227 | 227 |
| 228 | 229 | 232 | 234 | 234 | 238 | 240 | 242 | 242 | 242 |
| 244 | 246 | 253 | 253 | 255 | 258 | 282 | 290 | 314 | 319 |
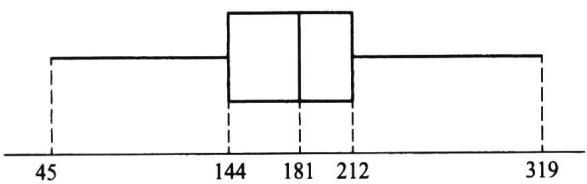
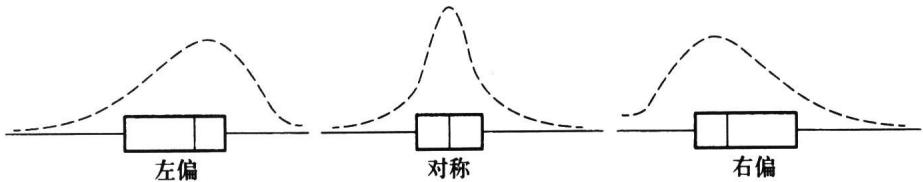
箱线图可用来对样本数据分布的形状进行大致的判断.图 5.3.8 给出三种常见的箱线图,分别对应左偏分布、对称分布和右偏分布.
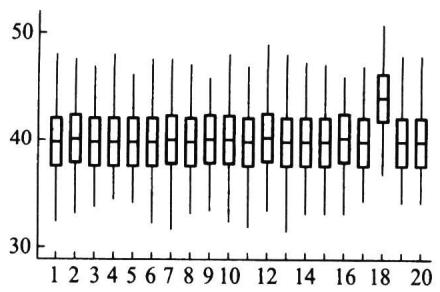
如果我们要对几批数据进行比较,则可以在一张纸上同时画出这几批数据的箱线图.图 5.3.9是根据某厂20天生产的某种产品的直径数据画成的箱线图,从图中可以清楚地看出,第18天的产品出现了异常.
- 在一本书上我们随机地检查了 10 页,发现每页上的错误数为:
4 5 6 0 3 1 4 2 1 4
Section titled “4 5 6 0 3 1 4 2 1 4”试计算其样本均值、样本方差和样本标准差. 2. 证明: 对任意常数 c, d,有
∑_ i = 1 ^ n (x _ i - c) (y _ i - d) = ∑_ i = 1 ^ n (x _ i - bar x) (y _ i - bar y) + n (bar x - c) (bar y - d).- 设 x₁, x₂, …, xₙ 和 y₁, y₂, …, yₙ 是两组样本观测值,且有如下关系:
试求样本均值 barx 和 bary 间的关系以及样本方差 sₓ² 和 s_(y)² 间的关系. 4. 记 barxₙ=1/n∑ᵢ=1ⁿxᵢ,sₙ²=(1)/(n-1)∑ᵢ=1ⁿ(xᵢ-barxₙ)²,n=1,2,…, 证明:
overline x _ n + 1 = overline x _ n + frac 1n + 1 (x _ n + 1 - overline x _ n),s _ n + 1 ^ 2 = frac n - 1n s _ n ^ 2 + frac 1n + 1 (x _ n + 1 - overline x _ n) ^ 2.- 从同一总体中抽取两个容量分别为 n, m 的样本,样本均值分别为 overlinex₁, overlinex₂ ,样本方差分别为 s₁², s₂² ,将两组样本合并,其均值、方差分别为 overlinex, s² ,证明:
- 设有容量为 n 的样本 A,它的样本均值为 barx_A,样本标准差为 s_A,样本极差为 R_A,样本中位数为 m_A.现对样本中每一个观测值施行变换
如此得到样本 B,试写出样本 B 的均值、标准差、极差和中位数。 7. 证明: 容量为 2 的样本 x₁, x₂ 的方差为
s ^ 2 = frac 12 (x _ 1 - x _ 2) ^ 2.- 设 x₁, x₂, …, xₙ 是来自 U(-1, 1) 的样本,试求 E(barx) 和 operatornameVar(barx) .
- 设总体二阶矩存在,x₁, x₂, …, xₙ 是样本,证明 xᵢ - barx 与 xⱼ - barx (i ≠ j) 的相关系数为 -(n - 1)⁻1 .
- 设 x₁, x₂, …, xₙ 为一个样本, s² = (1)/(n - 1) ∑ᵢ=1ⁿ (xᵢ - barx)² 是样本方差,试证:
- 设总体 4 阶中心矩 ν₄ = E[x - E(x)]⁴ 存在,试证: 对样本方差 s² = (1)/(n - 1) ∑ᵢ=1ⁿ (xᵢ - barx)²,有
其中 σ² 为总体 X 的方差. 12. 设总体 X 的 3 阶矩存在,若 x₁, x₂, …, xₙ 是取自该总体的简单随机样本,barx 为样本均值,s² 为样本方差,试证: Cov(barx, s²) = fracν₃n,其中 ν₃ = E[x - E(x)]³ . 13. 设 overlinex₁ 与 overlinex₂ 是从同一正态总体 N(μ, σ²) 独立抽取的容量相同的两个样本均值.试确定样本容量 n,使得两样本均值的差超过 σ 的概率不超过 0.01. 14. 利用切比雪夫不等式求抛均匀硬币多少次才能使正面朝上的频率落在(0.4,0.6)间的概率至少为0.9.如何才能更精确地计算这个次数?是多少? 15. 从指数总体 Exp(1 / θ) 抽取了40个样品,试求 overlinex 的渐近分布. 16. 设 x₁, x₂, …, x₂5 是从均匀分布 U(0,5) 抽取的样本,试求样本均值 barx 的渐近分布. 17. 设 x₁, x₂, …, x₂0 是从二点分布 b(1, p) 抽取的样本,试求样本均值 barx 的渐近分布. 18. 设 x₁, x₂, …, x₈ 是从正态总体 N(10,9) 中抽取的样本,试求样本均值 barx 的标准差. 19. 切尾均值也是一个常用的反映样本数据的特征量,其想法是将数据的两端的值舍去,而用剩下的当中的值来计算样本均值,其计算公式是
overline x _ α = frac x _ ([ n α ] + 1) + x _ ([ n α ] + 2) + … + x _ (n - [ n α ])n - 2 [ n α ],其中 0<α<1/2 是切尾系数, x_((1))≤slant x_((2))≤slant…≤slant x_((n)) 是有序样本。现我们在某高校采访了 16 名大学生,了解他们平时的学习情况,以下数据是大学生每周用于看电视的时间(单位:h):
l l l l l l l l l l l l l l l 1 5 & 1 4 & 1 2 & 9 & 2 0 & 4 & 1 7 & 2 6 & 1 5 & 1 8 & 6 & 1 0 & 1 6 & 1 5 & 5 & 8取 α=1/16 ,试计算其切尾均值. 20. 有一个分组样本如下:
| 区间 | 组中值 | 频数 |
| (145,155] | 150 | 4 |
| (155,165] | 160 | 8 |
| (165,175] | 170 | 6 |
| (175,185] | 180 | 2 |
| 批号 | 批量 | 不合格品率 |
| 1 | 100 | 0.05 |
| 2 | 300 | 0.06 |
| 3 | 250 | 0.04 |
| 4 | 150 | 0.03 |
现从中得到样本 x₁, x₂, …, xₙ ,证明 x_((1)) 仍服从韦布尔分布,并指出其参数. 26. 设总体密度函数为 p(x)=6x(1-x) , 0<x<1, x₁, x₂, …, x₉ 是来自该总体的样本,试求样本中位数的分布. 27. 证明公式 ∑ₖ=0^(r)binomnkp^(k)(1-p)ⁿ-k=(n!)/(r!(n-r-1)!)∫ₚ¹x^(r)(1-x)ⁿ-r-1dx, 其中 0≤slant p≤slant 1. 28. 设总体 X 的分布函数 F(x) 是连续的, x_((1)), x_((2)), …, x_((n)) 为取自此总体的次序统计量,设 ηᵢ = F(x_((i))) ,试证: (1) η₁ ≤slant η₂ ≤slant … ≤slant ηₙ ,且 ηᵢ 是来自均匀分布 U(0,1) 总体的次序统计量; (2) E(ηᵢ) = (i)/(n + 1),Var(ηᵢ) = (i(n + 1 - i))/((n + 1)²(n + 2)),1≤slant i≤slant n; (3) ηᵢ 和 ηⱼ 的协方差矩阵为
( l l frac a _ 1 (1 - a _ 1)n + 2 & frac a _ 1 (1 - a _ 2)n + 2 frac a _ 1 (1 - a _ 2)n + 2 & frac a _ 2 (1 - a _ 2)n + 2 ),其中 a₁ = (i)/(n + 1), a₂ = (j)/(n + 1) . 29. 设总体 X 服从 N(0,1) ,从此总体获得一组样本观测值 x₁ = 0, x₂ = 0.2, x₃ = 0.25, x₄ = -0.3, x₅ = -0.1, x₆ = 2, x₇ = 0.15, x₈ = 1, x₉ = -0.7, x₁0 = -1 . (1) 计算 x = 0.15 (即 x_((6)) )处的 E{F(x_((6)))} , operatornameVar{F(x_((6)))} ; (2) 计算 F(x_((6))) 在 x=0.15 的分布函数值. 30. 在下列密度函数下分别寻求容量为 n 的样本中位数 m₀.5 的渐近分布: (1) p(x) = 6x(1 - x),0 < x < 1; (2) p(x) = (1)/(√(2π)σ)exp {-((x - μ)²)/(2σ²)}; (3) p(x) = { ll2x, & 0 < x < 1, 0, & 其他; . (4) p(x) = (λ)/(2)e⁻λ |x| .
31. 设总体 X 服从双参数指数分布,其分布函数为
Section titled “31. 设总体 XX 服从双参数指数分布,其分布函数为”其中, -∞<μ<∞,σ>0,x_((1))≤slant x_((2))≤slant…≤slant x_((n)) 为样本的次序统计量.试证明: (n-i-1)(2)/(σ)(x_((i))-x_((i-1))) 服从自由度为2的 χ² 分布 (i=2,3,…,n) . 32. 设总体 X 的密度函数为
p ( x ) = { l l 3 x ^ 2 , & 0 < x < 1 , 0 , & text 其他 , .x_((1)) ≤slant x_((2)) ≤slant … ≤slant x_((5)) 为容量为5的取自此总体的次序统计量,试证 fracx_((2))x_((4)) 与 x_((4)) 相互独立. 33.(1)设 x_((1)) 和 x_((n)) 分别为容量 n 的样本的最小和最大次序统计量,证明极差 Rₙ = x_((n)) - x_((1)) 的分布函数
F _ R _ n (x) = n ∫_ - ∞ ^ ∞ [ F (y + x) - F (y) ] ^ n - 1 p (y) d y,其中 F(y) 与 p(y) 分别为总体的分布函数与密度函数; (2) 利用(1)的结论,求总体为指数分布 Exp(λ) 时,样本极差 Rₙ 的分布. 34. 设 x₁, x₂, …, xₙ 是来自 U(0, θ) 的样本, x_((1)) ≤slant x_((2)) ≤slant … ≤slant x_((n)) 为次序统计量,令
y _ i = frac x _ (i)x _ (i + 1), i = 1, 2, … , n - 1, y _ n = x _ (n),证明 y₁, y₂, …, yₙ 相互独立. 35. 对下列数据构造箱线图:
| 472 | 425 | 447 | 377 | 341 | 369 | 412 | 419 |
| 400 | 382 | 366 | 425 | 399 | 398 | 423 | 384 |
| 418 | 392 | 372 | 418 | 374 | 385 | 439 | 428 |
| 429 | 428 | 430 | 413 | 405 | 381 | 403 | 479 |
| 381 | 443 | 441 | 433 | 419 | 379 | 386 | 387 |
| 40.6 | 39.6 | 43.8 | 36.2 | 40.8 | 37.3 | 39.2 | 42.9 |
| 38.6 | 39.6 | 40.0 | 34.7 | 41.7 | 45.4 | 36.9 | 37.8 |
| 44.9 | 45.4 | 37.0 | 35.1 | 36.7 | 41.3 | 38.1 | 37.9 |
| 37.1 | 37.7 | 39.2 | 36.9 | 44.5 | 40.4 | 38.4 | 38.9 |
| 39.9 | 42.2 | 43.5 | 44.8 | 37.7 | 34.7 | 36.3 | 39.7 |
| 42.1 | 41.5 | 40.6 | 38.9 | 42.2 | 40.3 | 35.8 | 39.2 |