
5.2.1 经验分布函数
Section titled “5.2.1 经验分布函数”设 x₁, x₂, …, xₙ 是取自总体分布函数为 F(x) 的样本,若将样本观测值由小到大进行排列,记为 x_((1)), x_((2)), …, x_((n)) ,则 x_((1)), x_((2)), …, x_((n)) 称为有序样本,用有序样本定义如下函数
F _ n (x) = { l l 0, & text 当 x < x _ (1), k / n, & text 当 x _ (k) ≤slant x < x _ (k + 1), k = 1, 2, … , n - 1, 1, & text 当 x ≥slant x _ (n), .则 Fₙ(x) 是一非减右连续函数,且满足
F _ n (- ∞) = 0 text 和 F _ n (∞) = 1.由此可见, Fₙ(x) 是一个分布函数,称 Fₙ(x) 为该样本的经验分布函数.
某食品厂生产听装饮料,现从生产线上随机抽取 5 听饮料,称得其净重 (单位: g) 为
c c c c c 3 5 1 & 3 4 7 & 3 5 5 & 3 4 4 & 3 5 1这是一个容量为 5 的样本,经排序可得有序样本:
x _ (1) = 3 4 4, x _ (2) = 3 4 7, x _ (3) = 3 5 1, x _ (4) = 3 5 1, x _ (5) = 3 5 5,其经验分布函数(其图形如图 5.2.1 所示)为
F _ n (x) = { l l 0, & x < 3 4 4, 0. 2, & 3 4 4 ≤slant x < 3 4 7, 0. 4, & 3 4 7 ≤slant x < 3 5 1, 0. 8, & 3 5 1 ≤slant x < 3 5 5, 1, & x ≥slant 3 5 5. .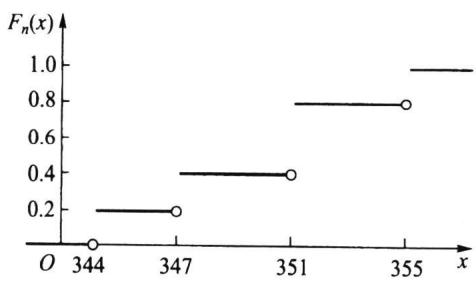
对每一固定的 x, Fₙ(x) 是样本中事件 {xᵢ ≤slant x} 发生的频率.当 n 固定时,Fₙ(x) 是样本的函数,它是一个随机变量.若对任意给定的实数 x,定义
I _ i (x) = { l l 1, & x _ i ≤slant x, 0, & x _ i > x, .则由经验分布函数的定义可以看出,对任意给定的实数 x
F _ n (x) = frac 1n ∑_ i = 1 ^ n I _ i (x).意到诸 Iᵢ(x) 是独立同分布的随机变量,其共同分布为 b(1, F(x)) ,由伯努利大数定律:只要 n 相当大, Fₙ(x) 依概率收敛于 F(x).更深刻的结果也是存在的,这就是格利文科定理,下面我们不加证明地加以介绍.
定理) 设 x₁, x₂, …, xₙ 是取自总体分布函数为 F(x) 的样本, Fₙ(x) 是其经验分布函数,当 n → ∞ 时,有
P (sup _ - ∞ < x < ∞ | F _ n (x) - F (x) | arrow 0) = 1.定理5.2.1 表明,当 n 相当大时,经验分布函数是总体分布函数 F(x) 的一个良好的近似.经典统计学中一切统计推断都以样本为依据,其理由就在于此.
5.2.2 频数频率表
Section titled “5.2.2 频数频率表”样本数据的整理是统计研究的基础,整理数据的最常用方法之一是给出其频数表或频率表.我们从一个例子开始介绍.
为研究某厂工人生产某种产品的能力,我们随机调查了 20 位工人某天生产的该种产品的数量,数据如下
| 160 | 196 | 164 | 148 | 170 |
| 175 | 178 | 166 | 181 | 162 |
| 161 | 168 | 166 | 162 | 172 |
| 156 | 170 | 157 | 162 | 154 |
方便起见,取组距为 10. (3)确定每组组限.各组区间端点为 a₀, a₀ + d = a₁, a₀ + 2d = a₂, …, a₀ + kd = aₖ ,形成如下的分组区间
(a _ 0, a _ 1 ], (a _ 1, a _ 2 ], … , (a _ k - 1, a _ k ],其中 a₀ 略小于最小观测值, aₖ 略大于最大观测值,本例中可取 a₀ = 147, a₅ = 197 ,于是本例的分组区间为:
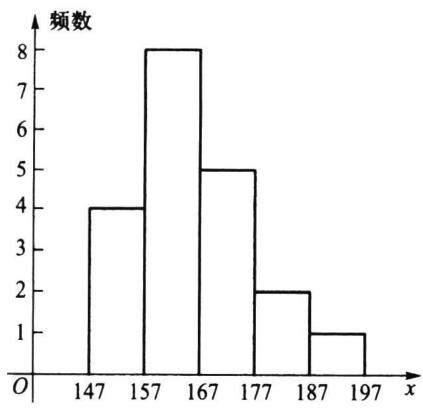
(1 4 7, 1 5 7 ], (1 5 7, 1 6 7 ], (1 6 7, 1 7 7 ], (1 7 7, 1 8 7 ], (1 8 7, 1 9 7 ],通常可用每组的组中值来代表该组的变量取值,组中值 = (组上限 + 组下限) / 2. (4)统计样本数据落入每个区间的个数——频数,并列出其频数频率表.本例的频数频率表见表5.2.1.从表中可以读出很多信息,如: 40% 的工人产量在157到167之间;产量少于167个的有12人,占 60% ;产量高于177的有3人,占 15% 表 5.2.1 例5.2.2 的频数频率表
| 组序 | 分组区间 | 组中值 | 频数 | 频率 | 累计频率/% |
| 1 | (147,157] | 152 | 4 | 0.20 | 20 |
| 2 | (157,167] | 162 | 8 | 0.40 | 60 |
| 3 | (167,177] | 172 | 5 | 0.25 | 85 |
| 4 | (177,187] | 182 | 2 | 0.10 | 95 |
| 5 | (187,197] | 192 | 1 | 0.05 | 100 |
| 合计 | 20 | 1 |
5.2.3 样本数据的图形显示
Section titled “5.2.3 样本数据的图形显示”前面我们介绍了频数频率分布的表格形式,它也可以用图形表示,这在许多场合更直观.
频数分布最常用的图形表示是直方图,它在组距相等场合常用宽度相等的长条矩形表示,矩形的高低表示频数的大小.在图形上,横坐标表示所关心变量的取值区间,纵坐标表示频数,这样就得到频数直方图,图5.2.2画出了例5.2.2的频数直方图.若把 纵轴改成频率就得到频率直方图. 为使诸长条矩形面积和为1,可将纵轴取为频率/组距,如此得到的直方图称为单位频率直方图,或简称频率直方图.凡此三种直方图的差别仅在于纵轴刻度的选择,直方图本身并无变化.
除直方图外,另一种常用的方法是茎叶图,下面我们从一个例子谈起.
某公司对应聘人员进行能力测 试,测试成绩总分为150分.下面是50位应聘人员的测试成绩(已经过排序):
| 64 | 67 | 70 | 72 | 74 | 76 | 76 | 79 | 80 | 81 |
| 82 | 82 | 83 | 85 | 86 | 88 | 91 | 91 | 92 | 93 |
| 93 | 93 | 95 | 96 | 96 | 97 | 97 | 99 | 100 | 100 |
| 102 | 104 | 106 | 106 | 107 | 108 | 108 | 112 | 112 | 114 |
| 116 | 118 | 119 | 119 | 122 | 123 | 125 | 126 | 128 | 133 |
| 数值 | 分开 | 茎 | 和 | 叶 | ||
| 112 | arrow | 1112 | arrow | 11 | 和 | 2 |
例5.2.4 下面的数据是某厂两个车间某天各 40 名员工生产的产品数量(表 5.2.2).为对其进行比较,我们将这些数据放到一个背靠背茎叶图上(图 5.2.4).
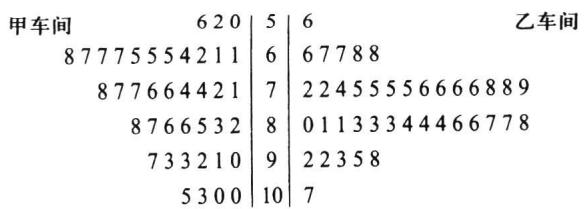
表 5.2.2 某厂两个车间 40 名员工的产量
| 甲车间 | 乙车间 | ||||||||||
| 50 | 52 | 56 | 61 | 61 | 62 | 56 | 66 | 67 | 67 | 68 | 68 |
| 64 | 65 | 65 | 65 | 67 | 67 | 72 | 72 | 74 | 75 | 75 | 75 |
| 67 | 68 | 71 | 72 | 74 | 74 | 75 | 76 | 76 | 76 | 76 | 78 |
| 76 | 76 | 77 | 77 | 78 | 82 | 78 | 79 | 80 | 81 | 81 | 83 |
| 83 | 85 | 86 | 86 | 87 | 88 | 83 | 83 | 84 | 84 | 84 | 86 |
| 90 | 91 | 92 | 93 | 93 | 97 | 86 | 87 | 87 | 88 | 92 | 92 |
| 100 | 100 | 103 | 105 | 93 | 95 | 98 | 107 | ||||
- 以下是某工厂通过抽样调查得到的 10 名工人一周内生产的产品数
试由这批数据构造经验分布函数并作图. 2. 下表是经过整理后得到的分组样本:
| 组序 | 1 | 2 | 3 | 4 | 5 |
| 分组区间 | (38,48] | (48,58] | (58,68] | (68,78] | (78,88] |
| 频数 | 3 | 4 | 8 | 3 | 2 |
-
假若某地区 30 名 2018 年某专业毕业生实习期满后的月薪数据如下:
(1) 构造该批数据的频率分布表(分 6 组); (2) 画出直方图.9 090 10 860 11 200 9 990 13 200 10 910 10 710 10 810 11 300 13 360 9 670 15 720 8 250 9 140 9 920 12 320 9 500 7 750 12 030 10 250 10 960 8 080 12 240 10 440 8 710 11 640 9 710 9 500 8 660 7 380 -
某公司对其 250 名职工上班所需时间 (单位: extmin) 进行了调查,下面是其不完整的频率分布表:
(1) 试将频率分布表补充完整; (2) 该公司上班所需时间在半小时以内的有多少人?所需时间 频率 0 ∼ 10 0.10 10 ∼ 20 0.24 20 ∼ 30 30 ∼ 40 0.18 40 ∼ 50 0.14 -
40 种刊物的月发行量(单位: 百册)如下:
(1) 建立该批数据的频数分布表,取组距为 1700 (百册); (2) 画出直方图.5 954 5 022 14 667 6 582 6 870 1 840 2 662 4 508 1 208 3 852 618 3 008 1 268 1 978 7 963 2 048 3 077 993 353 14 263 1 714 11 127 6 926 2 047 714 5 923 6 006 14 267 1 697 13 876 4 001 2 280 1 223 12 579 13 588 7 315 4 538 13 304 1 615 8 612 -
对下列数据构造茎叶图:
472 425 447 377 341 369 412 399 400 382 366 425 399 398 423 384 418 392 372 418 374 385 439 408 429 428 430 413 405 381 403 479 381 443 441 433 399 379 386 387 -
根据调查,某集团公司的中层管理人员的年薪(单位:万元)数据如下:
试画出茎叶图.40.6 39.6 37.8 36.2 38.8 38.6 39.6 40.0 34.7 41.7 38.9 37.9 37.0 35.1 36.7 37.1 37.7 39.2 36.9 38.3