数学期望和方差是随机变量最重要的两个特征数.此外,随机变量还有一些其他的特征数,以下逐一给出它们的定义,且解释它们的含义.
2.7.1 k 阶矩
Section titled “2.7.1 kk 阶矩”设 X 为随机变量,k 为正整数.如果以下的数学期望都存在,则称
μ_ k = E (X ^ k) (2.7.1)为 X 的 k 阶原点矩.称
ν_ k = E (X - E (X)) ^ k (2.7.2)为 X 的 k 阶中心矩. 显然,一阶原点矩就是数学期望,二阶中心矩就是方差.由于 |X|^(k-1)≤slant|X|^(k)+1,故k阶矩存在时, k-1阶矩也存在,从而低于k的各阶矩都存在. 中心矩和原点矩之间有一个简单的关系,事实上
ν_ _ k = E (X - E (X)) ^ k = E (X - μ_ _ 1) ^ k = ∑_ i = 0 ^ k binom k i μ_ _ i (- μ_ _ 1) ^ k - i,故前四阶中心矩可分别用原点矩表示如下:
l ν_ 1 = 0, ν_ 2 = μ_ 2 - μ_ 1 ^ 2, ν_ 3 = μ_ 3 - 3 μ_ 2 μ_ 1 + 2 μ_ 1 ^ 3, ν_ 4 = μ_ 4 - 4 μ_ 3 μ_ 1 + 6 μ_ 2 μ_ 1 ^ 2 - 3 μ_ 1 ^ 4.设随机变量 X ∼ N(0, σ²) ,则
μ_ k = E (X ^ k) = frac 1sqrt 2 π σ ∫_ - ∞ ^ ∞ x ^ k exp {- frac x ^ 22 σ^ 2 } d x = frac σ^ ksqrt 2 π ∫_ - ∞ ^ ∞ u ^ k exp {- frac u ^ 22 } d u.在 k 为奇数时,上述被积函数是奇函数,故
μ_ k = 0, k = 1, 3, 5, … .在 k 为偶数时,上述被积函数是偶函数,再利用变换 z = u² / 2 ,可得
r l μ_ k & = sqrt frac 2π σ^ k 2 ^ (k - 1) / 2 ∫_ 0 ^ ∞ z ^ (k - 1) / 2 e ^ - z d z = sqrt frac 2π σ^ k 2 ^ (k - 1) / 2 Γ (frac k + 12) & = σ^ k (k - 1) (k - 3) … 1. k = 2, 4, 6, … .故 N(0, σ²) 分布的前四阶原点矩为
μ_ 1 = 0, μ_ 2 = σ^ 2, μ_ 3 = 0, μ_ 4 = 3 σ^ 4.又因为 E(X)=0 ,所以有原点矩等于中心矩,即 μₖ=νₖ, k=1,2,…
2.7.2 变异系数
Section titled “2.7.2 变异系数”方差(或标准差)反映了随机变量取值的波动程度,但在比较两个随机变量的波动大小时,如果仅看方差(或标准差)的大小有时会产生不合理的现象.这有两个原因:(1)随机变量的取值有量纲,不同量纲的随机变量用其方差(或标准差)去比较它们的波动大小不太合理.(2)在取值的量纲相同的情况下,取值的大小有一个相对性问题,取值较大的随机变量的方差(或标准差)也允许大一些. 所以要比较两个随机变量的波动大小时,在有些场合使用以下定义的变异系数来进行比较,更具可比性.
设随机变量 X 的二阶矩存在,则称比值
C _ v (X) = frac sqrt operatornameVar (X)E (X) = frac σ (X)E (X) (2.7.3)为 X 的变异系数. 因为标准差的量纲与数学期望的量纲是一致的,所以变异系数是一个无量纲的量,从而消除量纲对波动的影响.
用 X 表示某种同龄树的高度,其量纲是米(m), 用 Y 表示某年龄段儿童的身高,其量纲也是米(m). 设 E(X)=10 , Var(X)=1 , E(Y)=1 , Var(Y)=0.04,是否可以从 Var(X)=1 和 Var(Y)=0.04 就认为 Y 的波动小? 这就有一个取值相对大小的问题.在此用变异系数进行比较是恰当的.因为 X 的变异系数为
C _ v (X) = frac σ (X)E (X) = frac 11 0 = 0. 1,而 Y 的变异系数为
C _ v (Y) = frac σ (Y)E (Y) = frac sqrt 0 . 0 41 = 0. 2,这说明 Y (儿童身高) 的波动比 X (同龄树高) 的波动大.
2.7.3 分位数
Section titled “2.7.3 分位数”设连续随机变量 X 的分布函数为 F(x),密度函数为 p(x).对任意 p ∈ (0,1),称满足条件
F (x _ p) = ∫_ - ∞ ^ x _ p p (x) d x = p (2.7.4)的 xₚ 为此分布的 p 分位数,又称下侧 p 分位数. 很多概率统计问题最后都归结为求解满足概率不等式 F(x) ≤slant p 的最大 x,其解可用分位数 xₚ 表示.为此人们对常用分布 (如正态分布、 t 分布、 χ² 分布等) 编制了各种分位数表 (见本书附表) 供实际使用. 分位数 xₙ 是把密度函数下的面积分为两块,左侧面积恰好为 p (见图 2.7.1(a)). 同理我们称满足条件
1 - F (x _ p ^ prime) = ∫_ x _ p ^ prime ^ ∞ p (x) d x = p (2.7.5)的 xₚ^(prime) 为此分布的上侧 p 分位数. 上侧分位数 xₚ^(prime) 也是把密度函数下的面积分为两块,但右侧面积恰好为 p (见图 2.7.1(b)).
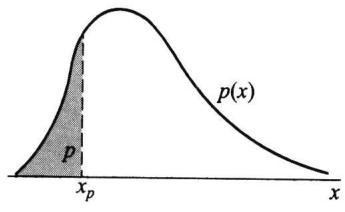 (a) 下侧分位数
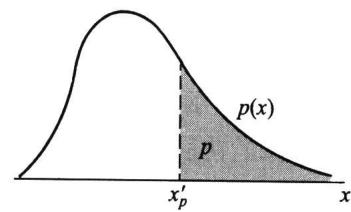 (b) 上侧分位数
要善于区分分位数(即下侧分位数)与上侧分位数的差别,本书指定用分位数表(即下侧分位数表),而有一些书使用的是上侧分位数表,无论用什么表,书中都有说明. 分位数与上侧分位数是可以相互转换的,其转换公式如下.
x _ p ^ prime = x _ 1 - p, x _ p = x _ 1 - p ^ prime.标准正态分布 N(0,1) 的 p 分位数记为 uₚ,它是方程
Φ (u _ p) = p (2.7.6)的唯一解,其解为 uₚ = Φ⁻1(p),其中 Φ⁻1(·) 是标准正态分布函数的反函数.利用标准正态分布函数表 (见附表 2), 我们可由 p 查得 uₚ.譬如 u₀.975 = 1.96.常用的标准正态分布的 p 分位数并不多,现列于表 2.7.1 上.由于标准正态分布的密度函数是偶函数,故其分位数有如下性质: - 当 p < 0.5 时,uₚ < 0 . - 当 p > 0.5 时,uₚ > 0 . - 当 p = 0.5 时, u₀.5 = 0 . - 当 p₁ < p₂ 时, uₚ₁ < uₚ₂ - 对任意的 p ,有 uₚ = -u₁ - p ,如 u₀.001 = -u₀.999 = -3.090 . 表 2.7.1 标准正态分布 p 分位数表 (部分)
| p | 0.999 | 0.995 | 0.990 | 0.975 | 0.950 | 0.900 | 0.850 | 0.800 |
| uₚ | 3.090 | 2.576 | 2.326 | 1.960 | 1.645 | 1.282 | 1.037 | 0.842 |
的解,所以由
frac x _ _ p - μσ = u _ _ p可得 xₚ 与 uₚ 的关系式
x _ p = μ + σ u _ p. (2.7.7)譬如正态分布 N(10,2²) 的0.975分位数为
x _ 0. 9 7 5 = 1 0 + 2 u _ 0. 9 7 5 = 1 0 + 2 × 1. 9 6 = 1 3. 9 2.记某种轴承的寿命为 T, tₚ 为此寿命分布的 p 分位数,则 t₀.1 = 1 000 h 表明此种轴承中约有 90% 寿命超过 1 000 h. 若记另一种轴承的寿命为 Z, p 分位数为 zₚ.则当 z₀.1 = 1 500 h 时,从 0.1 的分位数上说明后者的质量比前者更高一些:
2.7.4 中位数
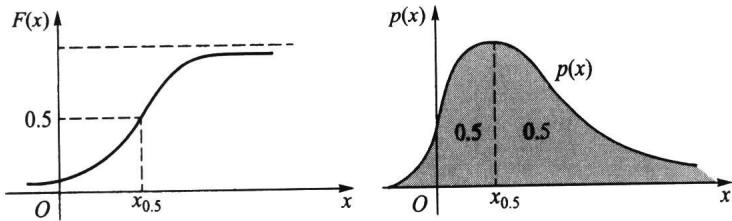
Section titled “2.7.4 中位数”设连续随机变量 X 的分布函数为 F(x),密度函数为 p(x).称 p = 0.5 时的 p 分位数 x₀.5 为此分布的中位数,即 x₀.5 满足
F (x _ 0. 5) = ∫_ - ∞ ^ x _ 0. 5 p (x) d x = 0. 5. (2.7.8)中位数的位置常在分布的中部,见图 2.7.2.
对离散分布也可以同样引入分位数和中位数的概念,但遗憾的是:此时对给定的p,有可能 xₚ 不存在或不唯一.所以在离散分布场合很少使用分位数,在这里我们不再予以讨论. 中位数与均值一样都是随机变量位置的特征数,但在某些场合可能中位数比均值更能说明问题.譬如,某班级学生的考试成绩的中位数为80分,则表明班级中有一半同学的成绩低于80分,另一半同学的成绩高于80分.而如果考试成绩的均值是80分,则无法得出如此明确的结论. 又譬如,记 X 为 A 国人的年龄,Y 为 B 国人的年龄,x₀.5 和 y₀.5 分别为 X 和 Y 的中位数,则 x₀.5 = 40 岁说明 A 国约有一半的人年龄小于等于 40 岁、一半的人年龄大于等于 40 岁.而 y₀.5 = 50 岁则说明 B 国更趋于老龄化.
指数分布 Exp(λ) 的中位数 x₀,5 是方程
1 - e ^ - λ x _ 0. 5 = 0. 5的解,解之得
x _ 0. 5 = frac ln 2λ.假如,某城市电话的通话时间 X (以 min 计) 服从均值 E(X)=2(min) 的指数分布,此时由 λ=0.5 可得中位数为
x _ 0. 5 = frac ln 20 . 5 = 1. 3 9 (min).它表明: 该城市中约有一半的电话在 1.39 min 内结束,另一半的通话时间超过 1.39 min.
设连续随机变量 X 的密度函数为
p (x) = { l l 4 x ^ 3, & 0 < x < 1, 0, & text 其他. .试求此分布的 0.95 分位数 x₀.95 和中位数 x₀.5 .
解
因为 X 的分布函数为
F (x) = { l l 0, & x < 0, x ^ 4, & 0 ≤slant x < 1, 1, & 1 ≤slant x. .所以由 F(x₀.95) = 0.95 可得: x₀.95⁴ = 0.95 ,由此得 x₀.95 = 4√(0.95) = 0.9873.同理由 F(x₀.5) = 0.5 得 x₀.5⁴ = 0.5 ,从中解得 x₀.5 = 4√(0.5) = 0.8409 .
2.7.5 偏度系数
Section titled “2.7.5 偏度系数”设随机变量 X 的前三阶矩存在,则比值
β_ s = frac ν_ 3ν_ 2 ^ 3 / 2 = frac E (X - E (X)) ^ 3[ operatornameVar (X) ] ^ 3 / 2称为 X (或分布)的偏度系数,简称偏度.当 βₛ > 0 时,称该分布为正偏,又称右偏;当 βₛ < 0 时,称该分布为负偏,又称左偏.
偏度 βₛ 是描述分布偏离对称性程度的一个特征数,这可从以下几方面来认识.
(1)当密度函数 p(x) 关于数学期望对称时,即有 p(E(X) - x) = p(E(X) + x) ,则其三阶中心矩 ν₃ 必为0,从而 βₛ = 0 。这表明关于 E(X) 对称的分布其偏度为0。譬如,正态分布 N(μ, σ²) 关于 E(X) = μ 是对称的,故任意正态分布的偏度皆为0。
(2)当偏度 βₛ ≠ 0 时,该分布为偏态分布,偏态分布常有不对称的两个尾部,重尾在右侧(变量在高值处比低值处有较大的偏离中心趋势)必导致 βₛ > 0 ,故此分布又称为右偏分布;重尾在左侧(变量在低值处比高值处有较大的偏离中心趋势)必导致 βₛ < 0 ,故又称为左偏分布,参见图 2.7.3.
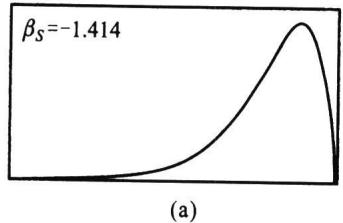
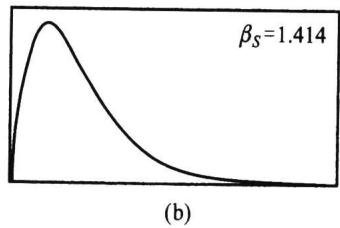
(3)偏度 βₛ 是以各自的标准差的三次方 [σ (X)]³ 为单位来度量三阶中心矩大小的,从而消去了量纲,使其更具有可比性.简单地说,分布的三阶中心矩 ν₃ 决定偏度的符号,而分布的标准差 σ (X) 决定偏度的大小.
讨论三个贝塔分布 Be(2,8) , Be(8,2) 和 Be(5,5) 的偏度.
解
设随机变量 X 服从贝塔分布 Be(a, b),则可算得其前三阶原点矩:
E (X) = frac aa + b,E (X ^ 2) = frac a (a + 1)(a + b) (a + b + 1),E (X ^ 3) = frac a (a + 1) (a + 2)(a + b) (a + b + 1) (a + b + 2).以下为简化 βₛ 的计算,特用 a+b=10, b=10-a 代入可算得前三阶中心矩.
E (X) = frac a1 0, operatornameVar (X) = frac a (1 0 - a)1 0 ^ 2 × 1 1, E (X - E (X)) ^ 3 = frac a (1 0 - a) (5 - a)1 0 ^ 3 × 1 1 × 3.可得贝塔分布的偏度为
β_ s = frac E (X - E (X)) ^ 3[ operatornameVar (X) ] ^ 3 / 2 = frac sqrt 1 1 (5 - a)3 sqrt a (1 0 - a),把 a=2,5,8 分别代入可得 Be(2,8) 的 βₛ=√(11)/4=0.8292 ,右偏(正偏), Be(5,5) 的 βₛ=0 ,对称, Be(8,2) 的 βₛ=-√(11)/4=-0.8292 ,左偏(负偏).
2.7.6 峰度系数
Section titled “2.7.6 峰度系数”设随机变量 X 的前四阶矩存在,则
β_ k = frac ν_ 4ν_ 2 ^ 2 - 3 = frac E (X - E (X)) ^ 4[ operatornameVar (X) ] ^ 2 - 3称为 X(或分布)的峰度系数,简称峰度. 峰度是描述分布尖峭程度和(或)尾部粗细的一个特征数,这可从以下几方面来认识. (1)正态分布 N(μ, σ²) 的 ν₂ = σ², ν₄ = 3σ⁴ ,故按上述定义,任一正态分布 N(μ, σ²) 的峰度 βₖ = 0 。可见这里谈论的“峰度”不是指一般密度函数的峰值高低,因为正态分布 N(μ, σ²) 的峰值为 (√(2π)σ)⁻1 ,它与正态分布标准差 σ 成反比, σ 愈小,正态分布的峰值愈高,可这里的“峰度”与 σ 无关。 (2)假如在上述定义中,分子与分母各除以 [σ (X)]⁴ ,并记 X 的标准化变量为 X^(*) = (X - E(X))/(σ(X)) ,则 βₖ 可改写成
β_ k = frac E (X ^ *) ^ 4[ E (X ^ * 2) ] ^ 2 - 3 = E (X ^ * 4) - E (U ^ 4),其中 E(X^(*2))=Var(X^(*))=1 , U 为标准正态变量,E(U⁴)=3 .
上式表明:峰度 βₖ 是相对于正态分布而言的超出量,即峰度 βₖ 是 X 的标准化变量与标准正态变量的四阶原点矩之差,并以标准正态分布为基准确定其大小.
- βₖ > 0 表示标准化后的分布比标准正态分布更尖峭和(或)尾部更粗(见图 2.7.4(b 表示标准化后的分布比标准正态分布更平坦和(或)尾部更细(见图 2.7.4)
(βₖ < 0 表示标准化后的分布比标准正态分布更平坦和(或)尾部更细(见图2.7.4)
(a), 图中方形的曲线是均匀分布).
- βₖ = 0 表示标准化后的分布与标准正态分布的尖峭程度与尾部粗细相当.
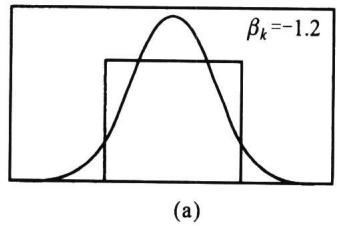
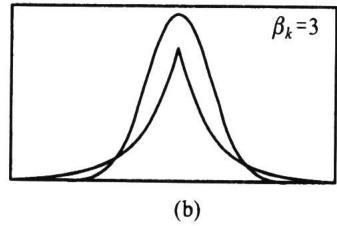
它们的均值相等、方差相等、偏度皆为0(对称分布),而峰度有很大差别 (3)偏度与峰度都是描述分布形状的特征数,它们的设置都是以正态分布为基准,正态分布的偏度与峰度皆为0。在实际中一个分布的偏度与峰度皆为0或近似为0时,常认为该分布为正态分布或近似为正态分布。 (4)表2.7.2上列出了几种常见分布的偏度与峰度,其中伽马分布 Ga(α, λ) 的偏度与峰度只与 α 有关,而与 λ 无关,故 α 常称为形状参数,而 λ 不能称为形状参数。均匀分布 U(a, b) 与指数分布 Exp(λ) 的偏度与峰度都与其所含参数无关,故均匀分布 U(a, b) 中的参数 a 与 b 、指数分布中的参数 λ 均不能称为形状参数。进一步的研究会发现,贝塔分布 Be(a, b) 的偏度与峰度与其参数 a 与 b 都有关,它们都可以称为形状参数。 表 2.7.2 几种常见分布的偏度与峰度
| 分布 | 均值 | 方差 | 偏度 | 峰度 |
| 均匀分布 U(a,b) | (a+b)/2 | (b-a)²/12 | 0 | -1.2 |
| 正态分布 N(μ,σ²) | μ | σ² | 0 | 0 |
| 指数分布 Exp(λ) | 1/λ | 1/λ² | 2 | 6 |
| 伽马分布 Ga(α,λ) | α/λ | α/λ² | 2/√(α) | 6/α |
计算伽马分布 Ga(α,λ) 的偏度与峰度.
解
首先计算伽马分布 Ga(α, λ) 的 k 阶原点矩:
μ_ k = E (X ^ k) = α (α + 1) … (α + k - 1) / λ^ k.当 k = 1,2,3,4 时可得前四阶原点矩
l μ_ 1 = α / λ , μ_ 2 = α (α + 1) / λ^ 2, μ_ 3 = α (α + 1) (α + 2) / λ^ 3, μ_ 4 = α (α + 1) (α + 2) (α + 3) / λ^ 4.由此可得 2、3、4 阶中心矩
l ν_ 2 = μ_ 2 - μ_ 1 ^ 2 = α / λ^ 2, ν_ 3 = μ_ 3 - 3 μ_ 2 μ_ 1 + 2 μ_ 1 ^ 2 = 2 α / λ^ 3,ν_ 4 = μ_ 4 - 4 μ_ 3 μ_ 1 + 6 μ_ 2 μ_ 1 ^ 2 - 3 μ_ 1 ^ 4 = 3 α (α + 2) / λ^ 4.最后可得伽马分布 Ga(α, λ) 的偏度与峰度
β_ s = frac ν_ 3ν_ 2 ^ 3 / 2 = frac 2sqrt α,β_ k = frac ν_ 4ν_ 2 ^ 2 - 3 = frac 6α.可见,伽马分布 Ga(α,λ) 的偏度与 √(α) 成反比.峰度与 α 成反比.只要 α 较大,可使 βₛ 与 βₖ 接近于 0,从而伽马分布也愈来愈近似正态分布.
- 设随机变量 X ∼ U(a, b),对 k = 1, 2, 3, 4,求 μₖ = E(X^k) 与 νₖ = E(X - E(X))^k.进一步求此分布的偏度系数和峰度系数.
- 设随机变量 X ∼ U(0, a),求此分布的变异系数.
- 求以下分布的中位数: (1) 区间 (a,b) 上的均匀分布; (2) 正态分布 N(μ, σ²) ; (3) 对数正态分布 LN(μ, σ²) .
- 设随机变量 X ∼ Ga(α, λ),对 k = 1, 2, 3,求 μₖ = E(X^k) 与 νₖ = E(X - E(X))^k .
- 设随机变量 X ∼ Exp(λ),对 k = 1, 2, 3, 4,求 μₖ = E(X^k) 与 νₖ = E(X - E(X))^k.进一步求此分布的变异系数、偏度系数和峰度系数.
- 设随机变量 X 服从正态分布 N(10,9) ,试求 x₀.1 和 x₀.9 .
- 设随机变量 X 服从双参数韦布尔分布,其分布函数为
其中 η > 0, m > 0.试写出该分布的 p 分位数 xₚ 的表达式,且求出当 m = 1.5, η = 1000 时的 x₀.1, x₀.5, x₀.8 的值. 8. 自由度为 2 的 χ² 分布的密度函数为
p (x) = frac 12 e ^ - frac x2, x > 0.试求出其分布函数及分位数 x₀.1, x₀.5, x₀.8 .
9. 设随机变量 X 的分布密度函数 p(x) 关于直线 x = c 是对称的,且 E(X) 存在,试证:
(1) 这个对称点 c 既是均值又是中位数,即 E(X)=x₀.5=c ;
(2) 如果 c=0,则 xₚ=-x₁-p .
10. 试证随机变量 X 的偏度系数与峰度系数对位移和改变比例尺是不变的,即对任意的实数 a , b (b ≠ 0) , Y = a + bX 与 X 有相同的偏度系数与峰度系数.
11. 设某项维修时间 T (单位: 分) 服从对数正态分布 LN(μ, σ²) .
(1) 求 p 分位数 tₚ ;
(2) 若 μ=4.1271 ,求该分布的中位数;
(3) 若 μ=4.127 1,σ=1.036 4 ,求完成 95% 维修任务的时间.
12. 某种绝缘材料的使用寿命 T (单位: 小时) 服从对数正态分布 LN(μ, σ²).若已知分位数 t₀.2 =
5 000 小时,t₀.8=65 000 小时,求 μ 和 σ .
13. 某厂决定按过去生产状况对月生产额最高的 5% 的工人发放高产奖.已知过去每人每月生产额 X (单位: 千克) 服从正态分布 N(4000, 60²),试问高产奖发放标准应把生产额定为多少?