
前面讨论的线性分组码与循环码属于“无记忆分组编码”:每个时段输出的 n 个码元仅受本组 k 个信息位约束,各码块之间互不关联。
卷积码(Convolutional Codes)则是 1955 年由埃利亚斯(Peter Elias)提出的有记忆线性时序网络编码:编码器在任意时段输出的 n 个码元,不仅取决于当前时段输入的 k 个信息位,还深度关联着前 K-1 个历史时段的信息比特。利用时间上的连续代数约束,卷积码具备强大的纠错能力,配合维特比算法构成了 3G/4G 移动通信、深空通信及卫星链路的核心基石。
9.5.1 卷积码的结构模型与三大解析表示法
Section titled “9.5.1 卷积码的结构模型与三大解析表示法”1. 结构参数与通用模型
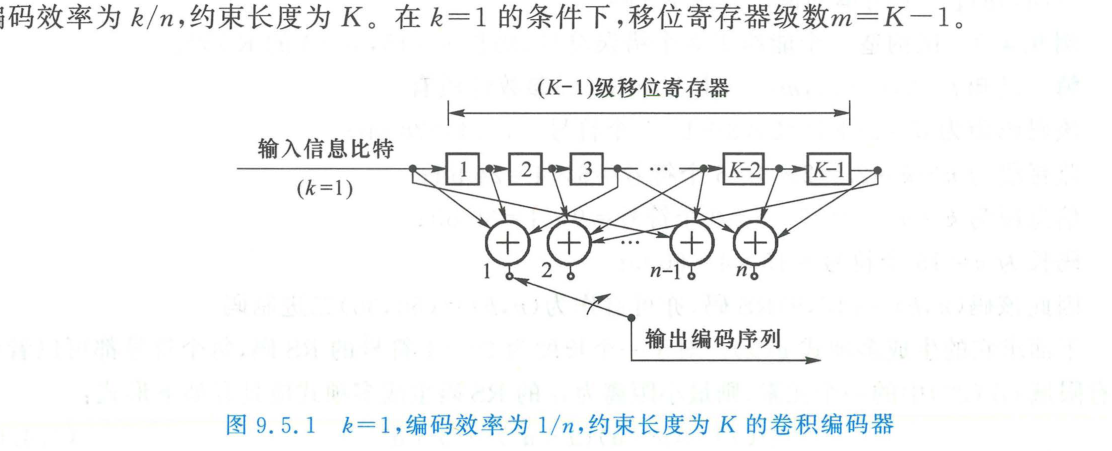
Section titled “1. 结构参数与通用模型”卷积码通常表示为 (n, k, K):
- k:每时钟周期输入的信息比特数(工程上通常 k=1);
- n:每时钟周期输出的编码比特数(编码效率 R = k/n);
- K:约束长度(Constraint Length),表示当前输出所关联的历史时段总跨度;
- m = K - 1:编码器中移位寄存器的级数(存储历史阶数),系统记忆总比特数为 mk。
以最经典的 (2, 1, 4) 卷积码(k=1, n=2, K=4, m=3)为例:
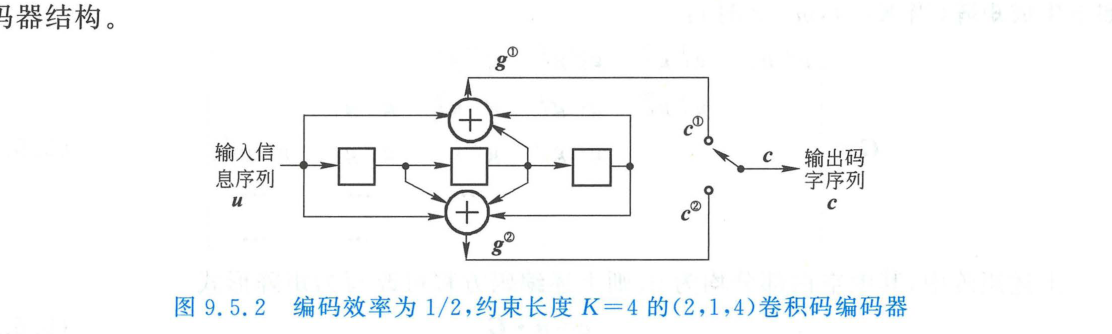
2. 解析表示法一:离散时域卷积(Discrete Convolution)
Section titled “2. 解析表示法一:离散时域卷积(Discrete Convolution)”设输入信息序列为 u = (u₀, u₁, u₂, …)。 当输入序列为单冲激脉冲 u = (1, 0, 0, …) 时,编码器各输出支路产生的响应序列称为冲激响应序列(生成序列) g^((j)):
g^((1)) = (g₀^((1)), g₁^((1)), …, gₘ^((1))), g^((2)) = (g₀^((2)), g₁^((2)), …, gₘ^((2)))对于任意信息输入,各支路输出即为输入序列与对应生成序列的离散线性卷积:
c^((1)) = u * g^((1)), c^((2)) = u * g^((2))最终交错并串转换输出总码字序列:
c = (c₀^((1)) c₀^((2)), c₁^((1)) c₁^((2)), c₂^((1)) c₂^((2)), …)这正是“卷积码”名称的数学本源。
3. 解析表示法二:半无限生成矩阵(Semi-Infinite Generator Matrix)
Section titled “3. 解析表示法二:半无限生成矩阵(Semi-Infinite Generator Matrix)”将生成序列按时序交错对齐排列,写为矩阵形式 c = u G:
G = g₀^((1)) g₀^((2)) & g₁^((1)) g₁^((2)) & … & gₘ^((1)) gₘ^((2)) & 0 0 & … 0 0 & g₀^((1)) g₀^((2)) & g₁^((1)) g₁^((2)) & … & gₘ^((1)) gₘ^((2)) & … 0 0 & 0 0 & g₀^((1)) g₀^((2)) & g₁^((1)) g₁^((2)) & … & … vdots & vdots & vdots & ddots & ddots & …生成矩阵 G 呈现为沿对角线阶梯平移的半无限托普利茨(Toeplitz)结构,适合理论空间分析。
4. 解析表示法三:码多项式法(Polynomial Representation)
Section titled “4. 解析表示法三:码多项式法(Polynomial Representation)”将序列表示为时延算子 x 的多项式:
u(x) = ∑ₗ uₗ x^l, g^((j))(x) = ∑ᵢ=0^m gᵢ^((j)) xⁱ各支路输出码多项式为:
c^((j))(x) = u(x) · g^((j))(x)多项式乘法在工程硬件计算与仿真中最为直观便捷。
9.5.2 卷积码的三大图形拓扑表示法
Section titled “9.5.2 卷积码的三大图形拓扑表示法”以广泛作为教学与工业基准的 (2, 1, 3) 卷积码(k=1, n=2, K=3, m=2)为例展开剖析:
- 生成多项式:g^((1))(x) = 1 + x + x²,对应连接系数 (111)₂;g^((2))(x) = 1 + x²,对应连接系数 (101)₂。
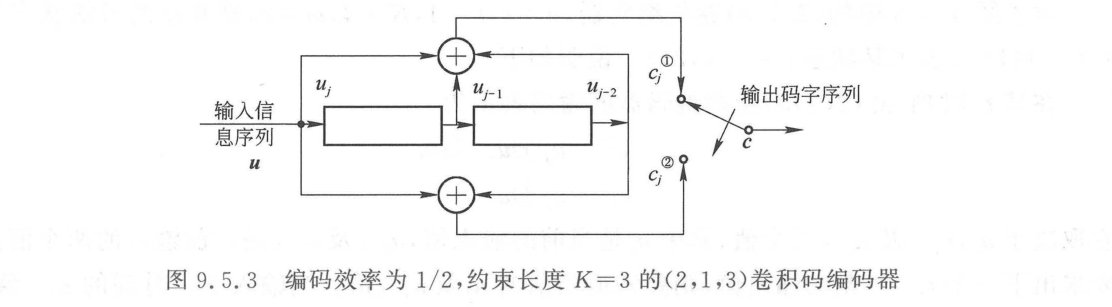
编码输出方程为:
cⱼ^((1)) = uⱼ oplus uⱼ-1 oplus uⱼ-2, cⱼ^((2)) = uⱼ oplus uⱼ-21. 状态图(State Diagram)
Section titled “1. 状态图(State Diagram)”编码器在 j 时刻的内部记忆状态由两级寄存器的现态唯一决定:
Sⱼ = (uⱼ-1, uⱼ-2) ∈ { s₀(00), s₁(10), s₂(01), s₃(11) }共有 2^m = 2² = 4 种可能状态。下一时刻状态转移仅取决于当前状态与新输入比特 uⱼ。
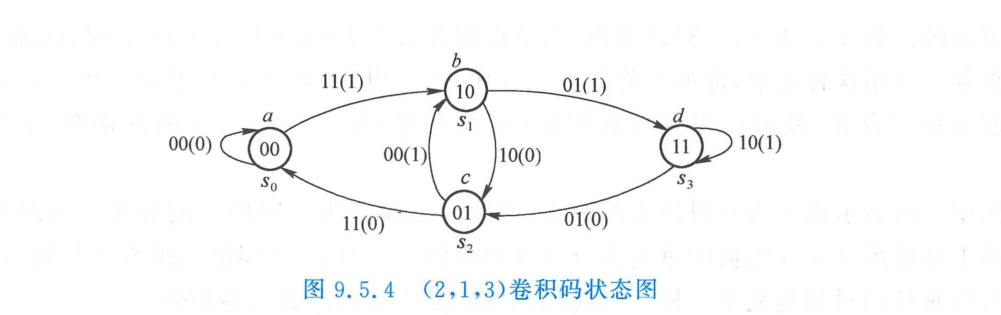
图中每个圆圈代表一个状态,有向弧线标注转移时的“输出码字(输入信息)”。状态图紧凑揭示了马尔可夫转移特性。
2. 树图(Tree Diagram)
Section titled “2. 树图(Tree Diagram)”若将状态转移沿时间轴逐级展开,以初始状态 s₀(00) 为根节点,输入 0 则向上分支,输入 1 则向下分支,形成随时间指数扩散的完全二叉树结构:
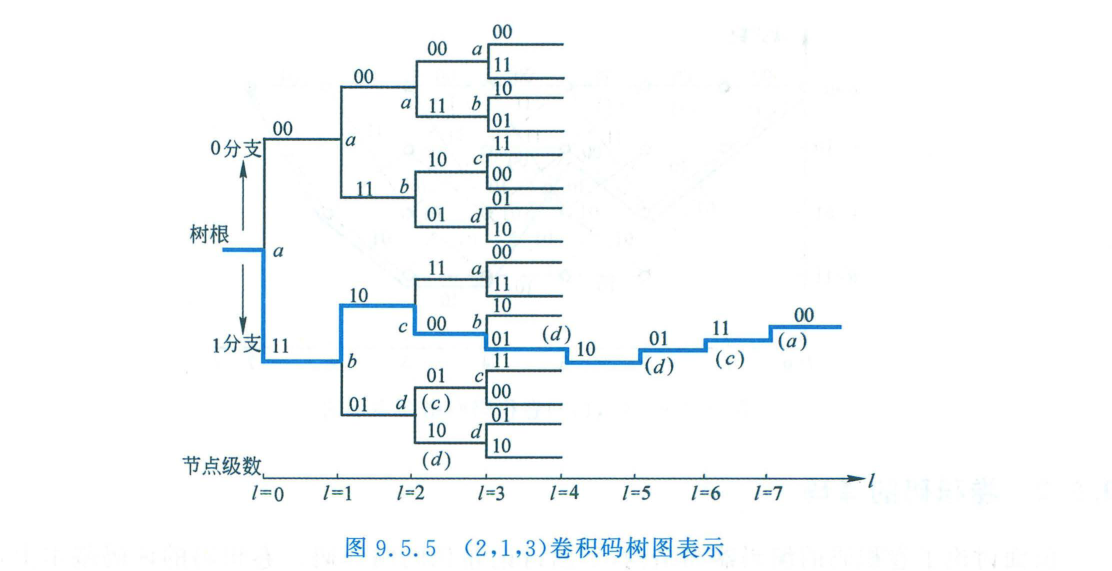
树图时序脉络完全清晰,每一条从根节点延伸出的独特路径均严格对应一个输入序列。但缺点是节点数量随时间按 2^l 几何级暴增。
3. 网格图(Trellis Diagram,篱笆图)
Section titled “3. 网格图(Trellis Diagram,篱笆图)”在树图中,当时间步长 l > m = 2 时,不同路径所到达的寄存器状态开始发生大量重合。若将同一时刻处于相同状态的节点折叠合并,二叉树便优雅地收敛为高度恒为 2^m = 4 的周期性格子拓扑——网格图(Trellis):
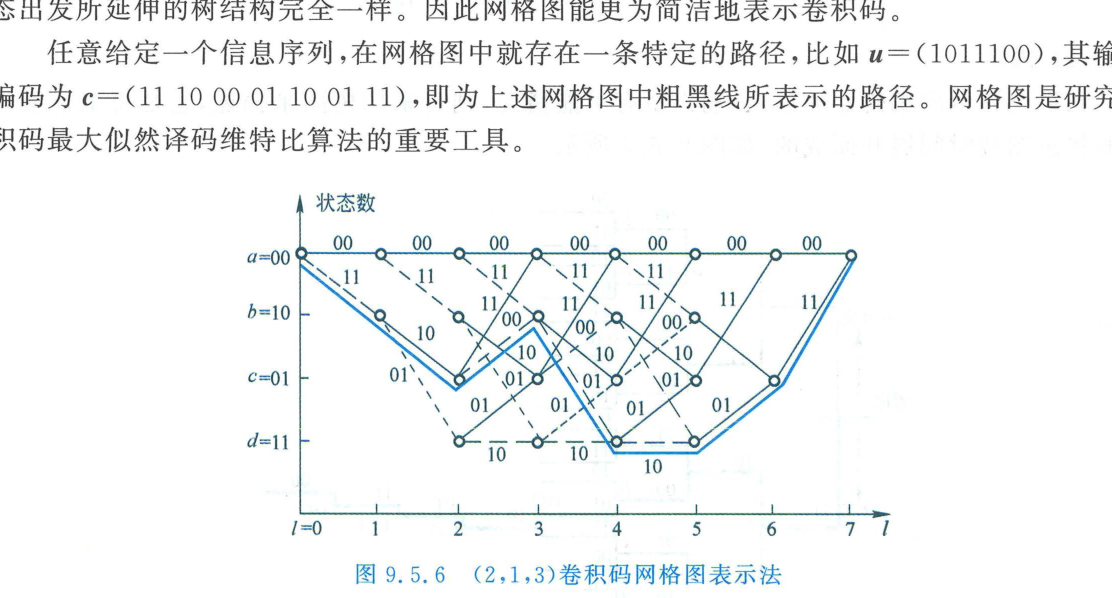
- 横轴:离散时间步 l = 0, 1, 2, …;
- 纵轴:2^m 个离散物理状态;
- 分支标号:实线表示输入 u=0,虚线表示输入 u=1;分支旁标注输出二元组 c^((1)) c^((2))。 网格图是所有现代概率图模型与维特比最优译码算法的物理宿主。
9.5.3 最大似然译码准则与汉明距离等价性
Section titled “9.5.3 最大似然译码准则与汉明距离等价性”设发端经网格图映射发射了码字序列 c,收端接收到受干扰序列 y。
根据最大后验概率(MAP)准则,在码字先验等概条件下,最优判决为最大似然(Maximum Likelihood, ML)准则:
hatc = argmax_(c ∈ mathcalC) log P(y|c)对于离散无记忆信道(DMC),长为 L 个符号的似然函数可分解为各时间步条件概率的乘积:
log P(y|c) = ∑ₗ=0^(L-1) log P(yₗ | cₗ)在转移概率为 p < 0.5 的二元对称信道(BSC)中:
log P(y|c) = d(y, c) log (p)/(1-p) + L log(1-p)由于 log (p)/(1-p) < 0,最大化对数似然函数严格等价于最小化累加汉明距离:
hatc = argmin_(c ∈ mathcalC) d(y, c) = argmin_(c ∈ mathcalC) ∑ₗ=0^(L-1) d(yₗ, cₗ)最大似然译码的物理本质:在网格图全部可能的连通路径中,搜寻一条与接收序列 y 汉明距离之和最小的全局最优路径!
9.5.4 维特比算法(Viterbi Algorithm)与动态规划
Section titled “9.5.4 维特比算法(Viterbi Algorithm)与动态规划”若采用蛮力穷举,长为 L 的序列拥有 2^L 条可能路径,计算量随帧长呈指数爆炸。 安德鲁·维特比(Andrew Viterbi)于 1967 年利用贝尔曼(Bellman)动态规划最优化原理,提出了革命性的网格图剪枝算法:
在网格图的任意时刻 l,若多条不同历史路径汇聚汇流至同一个状态节点 Sᵢ,则无论未来的接收序列如何,最终全局最优路径在 l 时刻之前的那段子路径,必然是这些汇流路径中累加度量最优(汉明距离最小)的那一条!
因此,对于进入该状态节点的全部竞选路径,仅需保留一条累加度量最小的最优路径(幸存路径,Survivor Path),其余所有竞争路径均可永久丢弃(剪枝),绝不影响全局最终判定!
1. 核心硬件算子:加-比-选(ACS, Add-Compare-Select)
Section titled “1. 核心硬件算子:加-比-选(ACS, Add-Compare-Select)”在每个时间步,对网格图中的每个状态执行流水线操作:
- 加(Add):将输入分支度量(当前接收符号与分支标签的汉明距离)加上前一时刻该状态累积的路径度量;
- 比(Compare):对汇聚到当前状态的各条输入分支总度量进行数值大小比对;
- 选(Select):选择度量值最小的分支,将其锁存为新的幸存路径度量并更新路径存储器(PM),其余路径直接切除。
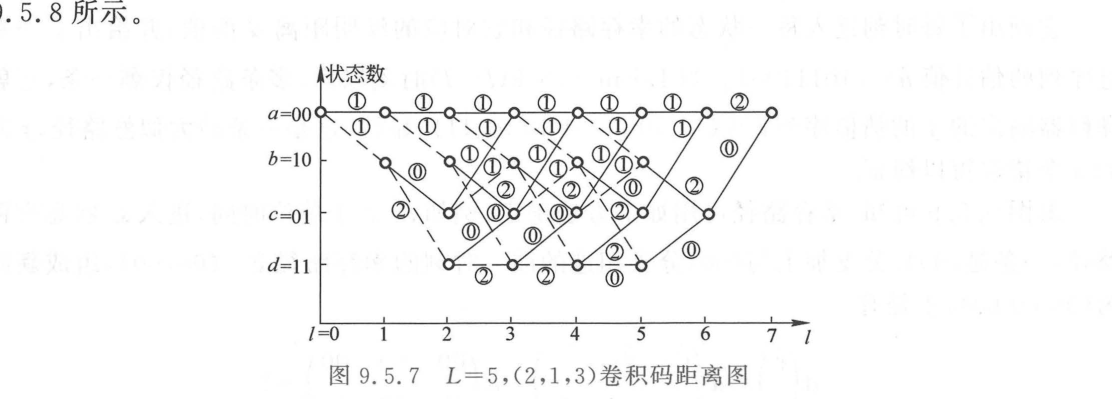 (a) 接收序列在网格图各分支上的汉明距离累加
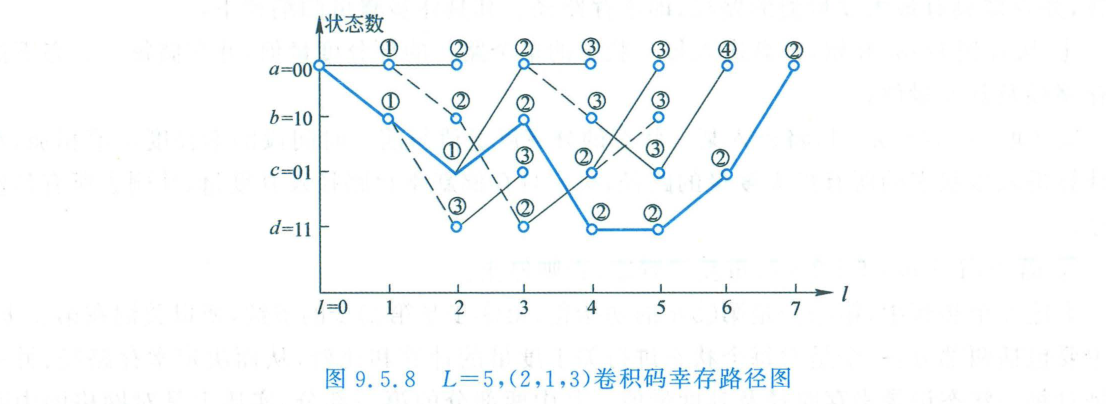 (b) 经 ACS 剪枝后保留的全局唯一粗黑幸存路径
发送端采用 (2, 1, 3) 卷积码(g^((1)) = 1+x+x², g^((2)) = 1+x²)。输入信息序列为 L=5 比特长 u = (1, 0, 1, 1, 1),并在尾部追加 m=2 个清除比特(Tail bits)0 0 使编码器最终可靠归零复位至 s₀(00)。
编码器总共输出 L+m = 7 组码字:
经恶劣信道传输后,接收端收到发生 3 处比特翻转的错误序列:
y = (10, 10, 00, 01, 11, 01, 10)(第 0 组、第 4 组、第 6 组各错 1 位)。试通过维特比算法推演逐步译码过程。
查看解析与步骤
维特比算法在每个时钟周期的网格图推演轨迹如下图所示:
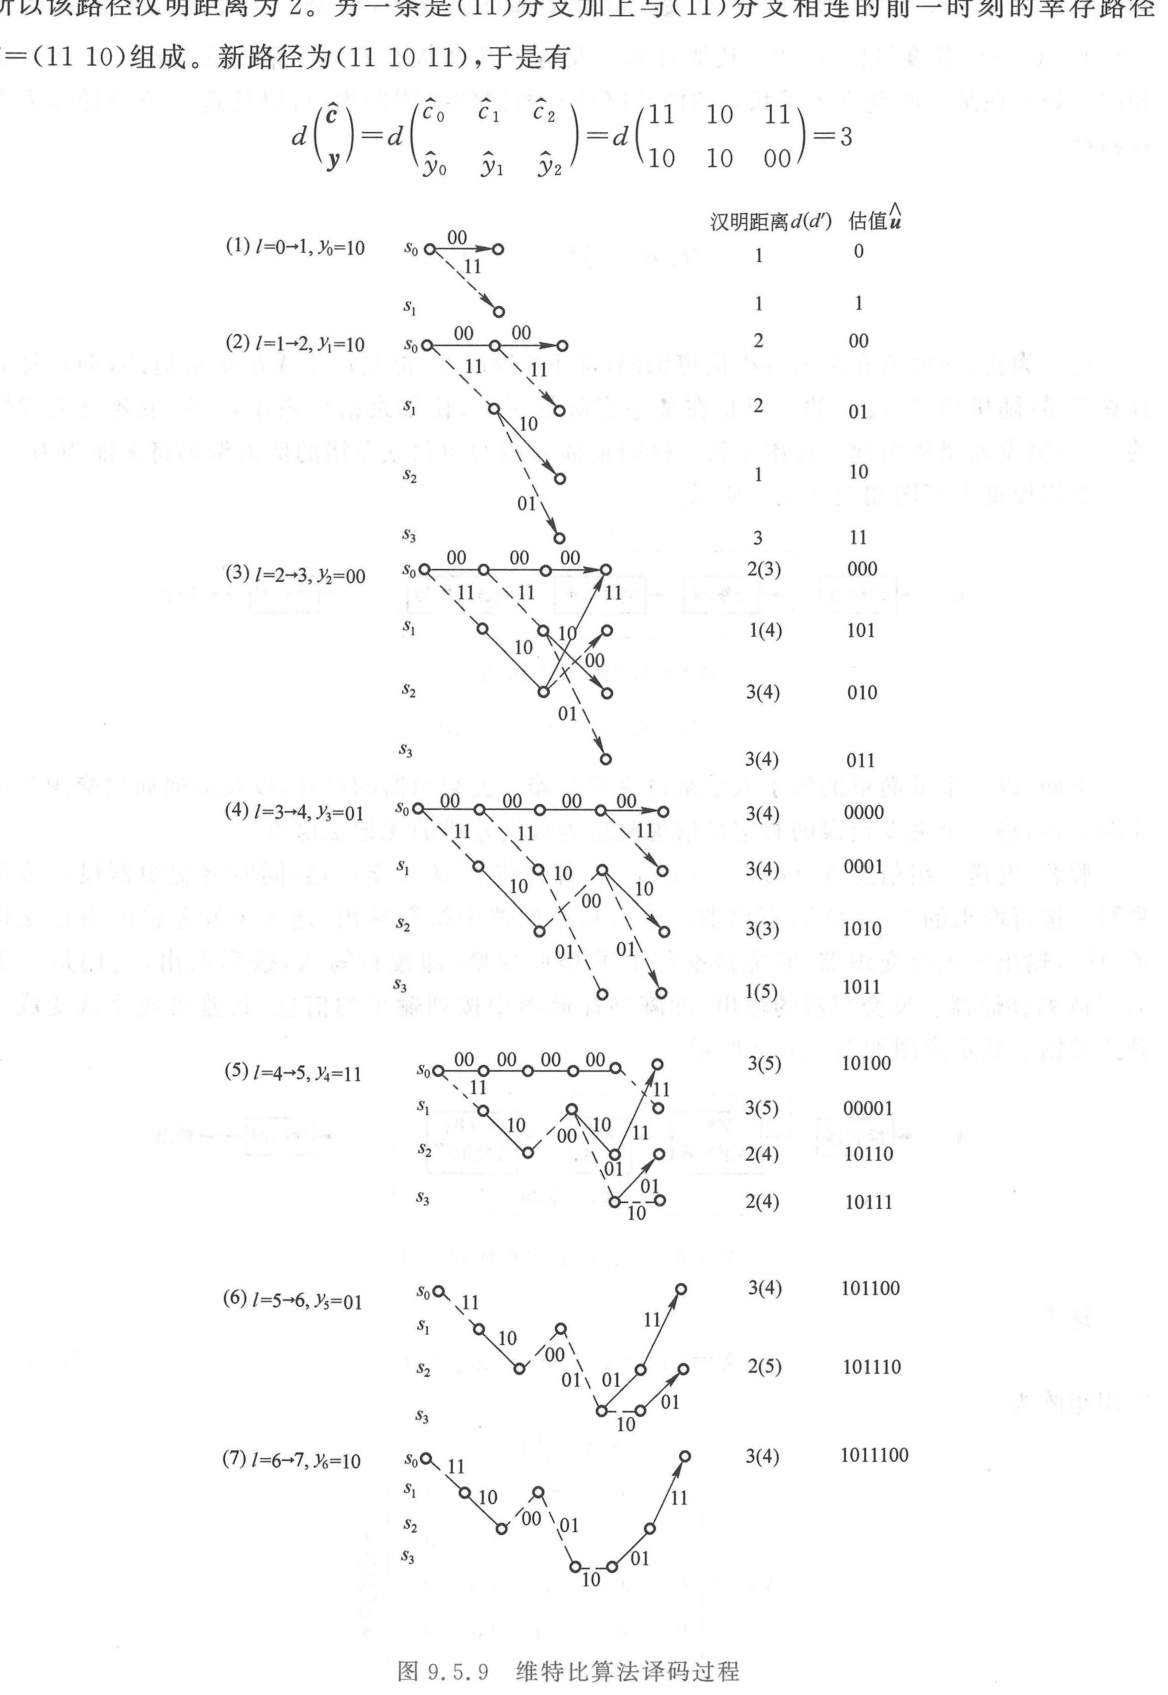
推演过程逐步展开如下:
- l = 0 → 1(接收 y₀ = 10):
- 始于 s₀(00)。输入 0 分支输出 00,分支距离 d(10, 00) = 1,到达状态 s₀(累加度量 1);
- 输入 1 分支输出 11,分支距离 d(10, 11) = 1,到达状态 s₁(累加度量 1)。
- l = 1 → 2(接收 y₁ = 10):
- 从 s₀ 延伸至 s₀(输出 00,度量 1+1=2)与 s₁(输出 11,度量 1+1=2);
- 从 s₁ 延伸至 s₂(输出 10,度量 1+0=1)与 s₃(输出 01,度量 1+2=3)。
- l = 2 → 3(网格图充满,ACS 正式启动,接收 y₂ = 00):
- 进入 s₀ 有两条路径:来自 s₀(分支 00,度量 2+0=2);来自 s₂(分支 11,度量 1+2=3)。
- 比选裁决:保留来自 s₀ 的路径,幸存度量锁存为 2,丢弃度量为 3 的分支;
- 类似地对 s₁, s₂, s₃ 各节点独立完成加比选。
- l = 3 → 7 持续推进迭代: 在 l=4(y₄ = 11)时,尽管信道再次发生突发翻转,但此前累积的度量差异使得正确路径的累加优势持续领先。
- l = 7 归零收敛与回溯(Traceback): 在第 7 步结束时,由于尾比特强制归零,最终汇聚于终点状态 s₀(00) 的全局幸存路径仅剩唯一一条(上图粗实线): s₀ → s₁ → s₂ → s₁ → s₃ → s₃ → s₂ → s₀ 该路径对应的译码输出码字为: hatc = (11, 10, 00, 01, 10, 01, 11) = c 沿幸存路径回溯各分支输入比特,成功恢复出原始发送信息: hatu = (1, 0, 1, 1, 1, 0, 0) implies 有效信息 (1, 0, 1, 1, 1) 信道中发生的全部 3 处随机比特错误被百分之百完全纠正!