
信道编码(Channel Coding,亦称差错控制编码)的核心使命是:在实际受限且存在加性噪声与物理畸变的传输信道中,通过对信息序列实施受控的代数变换与冗余扩展,最大限度抑制差错,保障数字传输的绝对可靠性。
9.1.1 信道差错类型与编码分类
Section titled “9.1.1 信道差错类型与编码分类”数字信号在物理信道传输中产生的差错模式与信道本身的物理冲击记忆特性紧密相关:
- 随机差错信道(无记忆信道):
- 机理:信道噪声对各个传输符号的作用在统计上相互独立,每个码元的翻转错误独立、随机出现。
- 典型信道:深空通信信道、卫星通信信道、视距微波中继信道、高品质同轴电缆与单模光纤。以加性高斯白噪声(AWGN)为主导。
- 对策:采用纠随机差错码(如汉明码、BCH 码、卷积码、LDPC 码)。
- 突发差错信道(有记忆信道):
- 机理:物理噪声与干扰具有明显的时间相关性或长脉冲特性,错误往往表现为密集集中出现的成串“突发错误群”,但错误群之间存在较长的时间间隙。
- 典型信道:短波电离层反射信道、移动无线多径衰落信道、高压电网脉冲干扰线缆以及高密度磁光存储介质(划痕、缺陷)。
- 对策:采用纠突发差错码(如 RS 码、循环交织纠错码)。
- 混合差错信道:
- 机理:同时叠加了独立离散的背景高斯白噪声与随机爆发的长突发深衰落脉冲。
- 对策:采用**级联码(Concatenated Codes)或交织技术(Interleaving)**与纠错码的组合体制。
9.1.2 受控冗余思想与重复码
Section titled “9.1.2 受控冗余思想与重复码”信道编码的本质是:根据严密的数学规则在待发送的 k 个信息比特中人为引入 r = n - k 个多余校验码元,利用多余度建立码字各分量之间的内在代数约束关系,从而赋予码组在接收端的检错与纠错能力。
衡量编码冗余代价的核心指标为编码效率(Code Rate,码率):
R = k/n (0 < R ≤ 1)1. 重复码(Repetition Code)机制对比
Section titled “1. 重复码(Repetition Code)机制对比”考虑发送 1 比特二进制信息 u ∈ {0, 1},采用不同程度的人为冗余扩展:
- 不重复传输(n=1, k=1, R=1):直接发送 0 或 1。信道翻转即导致不可察觉的错误,抗干扰能力为零;
- 重复一次传输(n=2, k=1, R=1/2):发送 00 或 11。若接收端出现 01 或 10,可判定发生单比特差错,但无法确定哪一位翻转,能检 1 错,不能纠错;
- 重复两次传输(n=3, k=1, R=1/3):发送 000 或 111。若接收端为 001、010、100,依据“多数表决”准则判决为发送 0;若接收端为 110、101、011,判决为发送 1。能纠正 1 个错,或检测 2 个错。
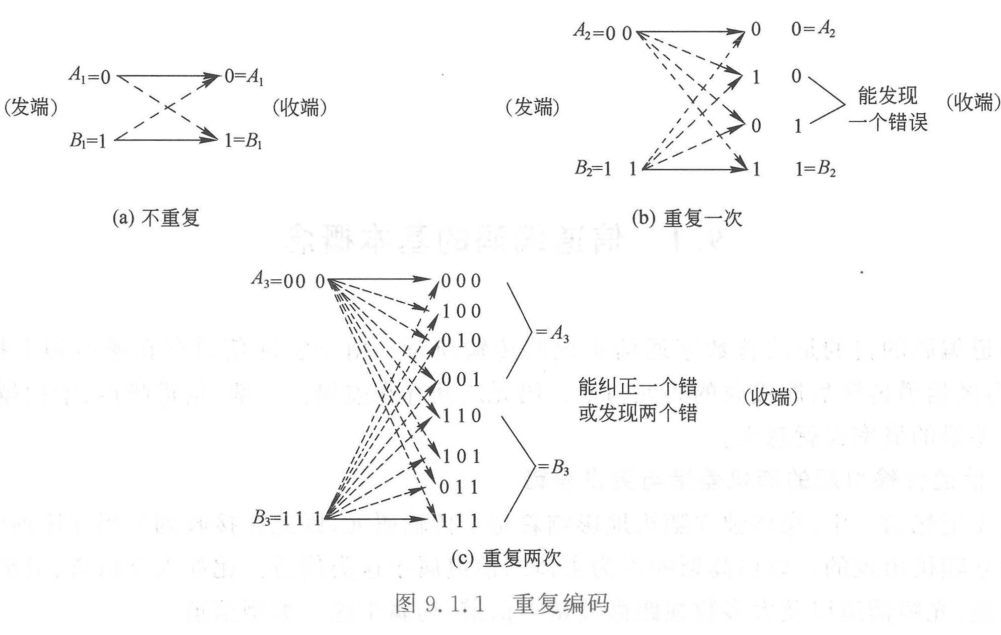
设二元对称信道的误比特率为 p = 0.01。发送二进制信息比特 u ∈ {0, 1},采用 n=3 的三重复码编码传输。接收端采用硬判决多数表决译码准则。 试求译码后的等效剩余误码率 Pₑ,并与未经编码的系统进行对比。
查看解析与步骤
发送码字为 c₀ = (0, 0, 0) 或 c₁ = (1, 1, 1)。 以发送 c₀ 为例,当且仅当接收码组中出现 2 个或 3 个比特翻转时,多数表决译码器才会判错。
译码后的剩余错误概率为:
Pₑ = binom32 p² (1 - p) + binom33 p³ = 3 p² (1 - p) + p³ = p²(3 - 2p)将 p = 0.01 代入:
Pₑ = (0.01)² × (3 - 0.02) = 10⁻4 × 2.98 = 2.98 × 10⁻4对比结论:采用三重复码后,误码率由 10⁻2 骤降至 2.98 × 10⁻4(改善近两个数量级)。但代价是传输效率跌落至 R = 1/3,占用了 3 倍的信道带宽。
9.1.3 汉明重量、汉明距离与检纠错能力判据
Section titled “9.1.3 汉明重量、汉明距离与检纠错能力判据”设编码输出长度为 n 的二元码字 c = (cₙ-1, cₙ-2, …, c₀) ∈ {0, 1}ⁿ。
1. 汉明重量(Hamming Weight)
Section titled “1. 汉明重量(Hamming Weight)”码字 c 中非零码元(“1”)的个数称为该码字的汉明重量,简记为 w(c):
w(c) = ∑ᵢ=0ⁿ-1 cᵢ2. 汉明距离(Hamming Distance)
Section titled “2. 汉明距离(Hamming Distance)”两个等长码字 c₁ 与 c₂ 在对应坐标位置上具有不同码元的数目,称为两个码字之间的汉明距离,简记为 d(c₁, c₂):
d(c₁, c₂) = w(c₁ oplus c₂)式中 oplus 为按位模 2 加法。
一个码集合中所有不同合法码字之间汉明距离的最小值,称为该码组的最小码距(Minimum Distance):
d_(min) = min_cᵢ ≠ cⱼ d(cᵢ, cⱼ)3. 最小码距与检纠错能力的关系
Section titled “3. 最小码距与检纠错能力的关系”在由 M = 2^k 个合法码字构成的超立方体顶点几何空间中,接收端根据最小距离译码准则,将接收向量 y 判决给与它汉明距离最近的合法码字 cᵢ。以每个合法码字 cᵢ 为中心、以 t 为汉明半径构成的判决超球体集合互不相交。
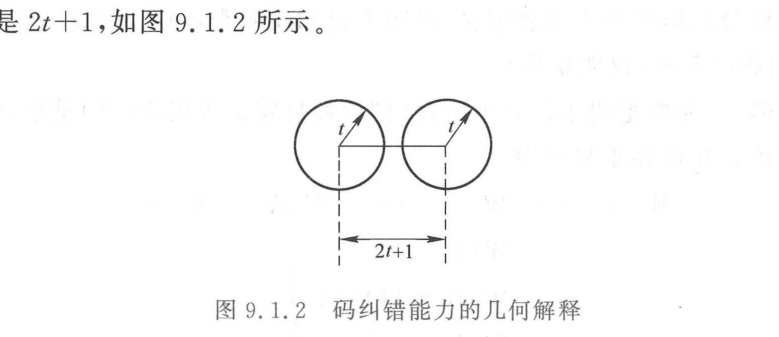
设某个分组码的最小汉明距离为 d_(min):
- 纯检错能力:若要能够检测出码字中发生的任何不超过 e 个的随机差错,充要条件为: d_(min) ≥ e + 1
- 纯纠错能力:若要能够纠正码字中发生的任何不超过 t 个的随机差错,充要条件为: d_(min) ≥ 2t + 1
- 同时纠检错能力:若要能够纠正不超过 t 个差错、同时检测出 e 个差错(e > t),充要条件为: d_(min) ≥ t + e + 1
9.1.4 奇偶校验码与漏检率分析
Section titled “9.1.4 奇偶校验码与漏检率分析”奇偶校验码是一类最简便的单比特检错系统码,记为 (n, n-1) 码。输入 n-1 个信息比特 (cₙ-1, …, c₁),附加 1 个校验比特 c₀。
- 偶校验码(Even Parity Code): 校验位 c₀ 强制使码字中“1”的总个数为偶数,满足模 2 线性约束方程: cₙ-1 oplus cₙ-2 oplus … oplus c₁ oplus c₀ = 0 iff c₀ = ∑ᵢ=1ⁿ-1 cᵢ ±od 2
- 奇校验码(Odd Parity Code): 强制使码字中“1”的总个数为奇数:∑ᵢ=0ⁿ-1 cᵢ = 1 ±od 2。⚠️ 奇校验码不满足线性代数封闭性,不属于线性码。
对于偶校验码,任意两个合法码字之间至少有两位不同(因为改变单个比特必然导致 1 的个数奇偶性翻转),故最小码距 d_(min) = 2。根据判据 d_(min) ≥ e + 1 = 2 implies e = 1,它能 100% 检测出所有奇数个(1、3、5…)传输比特差错,但完全无法检测偶数个(2、4…)比特差错。
构建一个 (4, 3) 偶校验码,校验比特位于最右端。设二元对称信道的单个码元独立错误概率为 p = 10⁻3。 试列出全部合法码字,分析其错误检测能力,并计算接收端发生差错却无法检测到的漏检概率 Pₑ。
查看解析与步骤
1. 合法码字集合构建: k=3 个信息比特共有 2³ = 8 种状态,依据 c₀ = c₃ oplus c₂ oplus c₁ 得到如下 8 个合法码字:
| 信息比特 (c₃ c₂ c₁) | 校验比特 c₀ | 完整码字 c |
|---|---|---|
0 0 0 | 0 | 0 0 0 0 |
1 0 0 | 1 | 1 0 0 1 |
0 1 0 | 1 | 0 1 0 1 |
1 1 0 | 0 | 1 1 0 0 |
0 0 1 | 1 | 0 0 1 1 |
1 0 1 | 0 | 1 0 1 0 |
0 1 1 | 0 | 0 1 1 0 |
1 1 1 | 1 | 1 1 1 1 |
2. 检错图样与漏检概率分析: 偶校验只能破坏奇数个错误的奇偶平衡性。因此,凡是在传输中发生 2 个比特翻转 或 4 个比特翻转 时,接收端校验和仍为 0,系统发生误判与漏检。
无法检测到的漏检概率为:
Pᵤndetected = binom42 p² (1 - p)² + binom44 p⁴ = 6 p² (1 - p)² + p⁴展开多项式:
Pᵤndetected = 6 p² - 12 p³ + 7 p⁴将 p = 10⁻3 代入,高阶项 p³, p⁴ 极小可忽略:
Pᵤndetected ≈ 6 × (10⁻3)² = 6 × 10⁻6漏检率仅为六百万分之一,展现了高性价比的检错效益。
9.1.5 差错控制的三大系统工作体制
Section titled “9.1.5 差错控制的三大系统工作体制”在工程通信网体系中,根据是否具备反向反馈信道以及如何协同处理差错,差错控制系统划分为三种核心体制:
- 前向纠错(Forward Error Correction, FEC):
- 工作原理:发端发射具备自动纠错能力的码组,收端译码器在差错数不超过纠错能力 t 时,自行定位并自动纠正差错,无需发端介入;
- 优缺点:无需反馈信道,单向通信即可完成,实时性极高,无往返时延;但编码器与译码算法复杂度较高,需占用较多校验开销;
- 适用场景:卫星与深空通信、单向广播数字电视、实时交互音视频及高速光纤骨干网。
- 检错重发(Automatic Repeat reQuest, ARQ):
- 工作原理:发端发送仅具备检错能力的码组(如 CRC)。收端若检出差错,立即通过反向反馈信道向发端发送否定应答(NAK),发端重新发送该数据帧,直至收端正确确认(ACK);
- 主要分类:停等式 ARQ(Stop-and-Wait)、退 N 步 ARQ(Go-Back-N)、选择性重传 ARQ(Selective Repeat);
- 优缺点:只需极少的多余校验码(5% ∼ 20%),译码电路极其简单;但严重依赖双向低延迟信道,恶劣信道下重传频繁导致吞吐量崩溃;
- 适用场景:计算机互联网络数据链路层与高层传输协议(如 TCP)。
- 混合自动重发请求(Hybrid ARQ, HARQ):
- 工作原理:现代移动通信(4G LTE / 5G NR)的核心机制。发端数据首先进行 CRC 检错编码,外层再套用高效 FEC 纠错编码。收端先利用 FEC 算法尝试前向纠正信道中的微弱差错;若差错严重超出 FEC 纠错能力,CRC 校验报错,此时触发 ARQ 请求发端重传增量冗余软信息,结合软合并(Chase Combining 或 Incremental Redundancy)进一步提升译码成功率。
9.1.6 伽罗华有限域 GF(2) 及其向量空间代数基础
Section titled “9.1.6 伽罗华有限域 GF(2) 及其向量空间代数基础”信道编码的严格数学建构深度依托近世代数(Modern Algebra)中的有限域(Galois Field)理论。
1. 二元有限域 GF(2)(或 mathbbF₂)
Section titled “1. 二元有限域 GF(2)GF(2)(或 mathbbF₂F2)”由二元离散集合 {0, 1} 及其上定义的模 2 加法 oplus 与模 2 乘法 · 构成:
| 模 2 加法 oplus | 0 | 1 |
|---|---|---|
| 0 | 0 | 1 |
| 1 | 1 | 0 |
| 模 2 乘法 · | 0 | 1 |
|---|---|---|
| 0 | 0 | 0 |
| 1 | 0 | 1 |
二元有限域具有重要性质:在 GF(2) 中,加法与减法完全等价(1 oplus 1 = 0 iff 1 = -1),不存在负号概念。
2. n 维二元向量空间 GF(2)ⁿ
Section titled “2. nn 维二元向量空间 GF(2)ⁿGF(2)n”由全体长度为 n 的二进制向量 x = (xₙ-1, xₙ-2, …, x₀) 构成的空间:
- 向量加法:按分量模 2 异或相加: x oplus y = (xₙ-1 oplus yₙ-1, xₙ-2 oplus yₙ-2, …, x₀ oplus y₀)
- 标量乘法:对于标量 a ∈ GF(2): a · x = (a · xₙ-1, a · xₙ-2, …, a · x₀)
GF(2)ⁿ 构成定义在二元域 GF(2) 上的 n 维向量空间。信道编码正是利用线性代数工具,在 n 维空间中构建一个维数为 k 的线性子空间,这一子空间便被称为线性分组码。