
自然界中的绝大多数原始信源(语音声波、自然图像、雷达回波、模拟传感数据)在时间与幅度上均为连续变化的模拟信号。然而在现代信息基础设施中,由于数字信号具备抗干扰与抗噪声积累能力强、易于高密度存储与加密运算、便于超大规模集成电路(VLSI)实现及多业务灵活复用等压倒性优势,模拟信号数字化(A/D 转换) 已成为现代通信技术发展的绝对基石。
由于连续模拟变量拥有不可数无穷多的状态(信息熵 H(X) = ∞),用有限位数字符号表示模拟连续量必然伴随失真,因此模拟信号数字化体系在信息论范畴内严格隶属于限失真信源编码(Lossy Source Coding)。
7.9.1 模拟信号数字化的基本原理
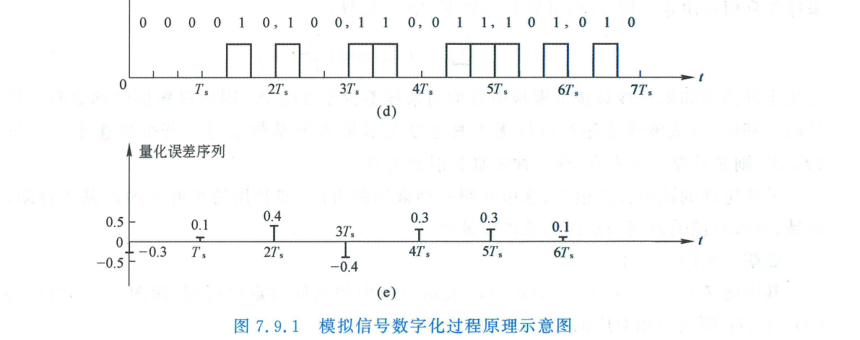
Section titled “7.9.1 模拟信号数字化的基本原理”模拟信号数字化(A/D 转换)在物理上严格涵盖三大有序步骤:采样(Sampling)、量化(Quantization) 与 编码(Coding)。
graph LR
    A["连续模拟信号 x(t)"] --> B["1. 采样 (Sampling)<br/>时间轴离散化"]
    B --> C["抽样样值序列 x(kTs)"]
    C --> D["2. 量化 (Quantization)<br/>取值域离散化 (引入限失真)"]
    D --> E["量化电平序列 y_k"]
    E --> F["3. 编码 (Coding)<br/>二进制码字映射"]
    F --> G["数字 PCM 脉冲序列"]
- 采样(时间离散化):按照一定的时间间隔 Tₛ 对连续时间信号 x(t) 瞬时抽样,将时间上连续的信号转换为时间轴离散的样值脉冲序列;
- 量化(幅度离散化):将取值连续的样值幅度四舍五入映射到有限个离散标准电平(量化级)上。量化误差是不可逆的,是导致信息损失的唯一物理环节;
- 编码(码字离散化):将离散量化电平按照预定规则转换为二进制码组(如 8 位二进制字节),合成基带数字码流。
7.9.2 采样定理(Sampling Theorem)
Section titled “7.9.2 采样定理(Sampling Theorem)”采样定理是连接模拟连续世界与数字离散世界的数理桥梁。
1. 低通采样定理(奈奎斯特采样定理)
Section titled “1. 低通采样定理(奈奎斯特采样定理)”设连续时间带限模拟信号 x(t) 的最高截止频率为 f_H(角频率 ω_H = 2π f_H),其傅里叶频谱 X(f) 在 |f| > f_H 时恒为零。
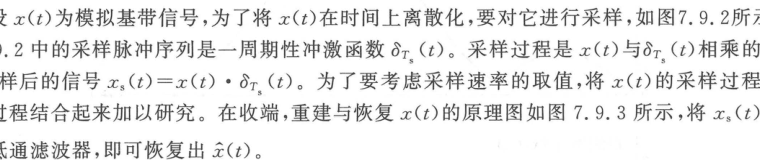
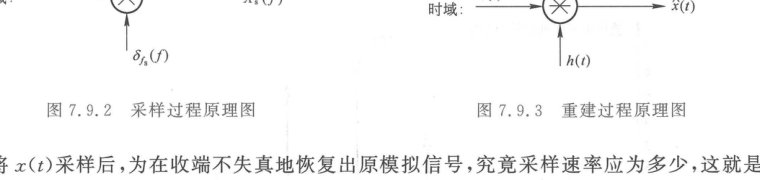
采样过程在数学上表现为信号 x(t) 与周期冲激脉冲序列 s(t) 的相乘:
xₛ(t) = x(t) · ∑ₖ=-∞^(∞) δ(t - k Tₛ) = ∑ₖ=-∞^(∞) x(k Tₛ) δ(t - k Tₛ)根据频域时域对应关系,抽样信号的傅里叶变换是原频谱 X(f) 以采样角频率 ωₛ = 2π / Tₛ 为周期的无限次周期拓延叠加:
Xₛ(f) = fₛ ∑ₙ=-∞^(∞) X(f - n fₛ)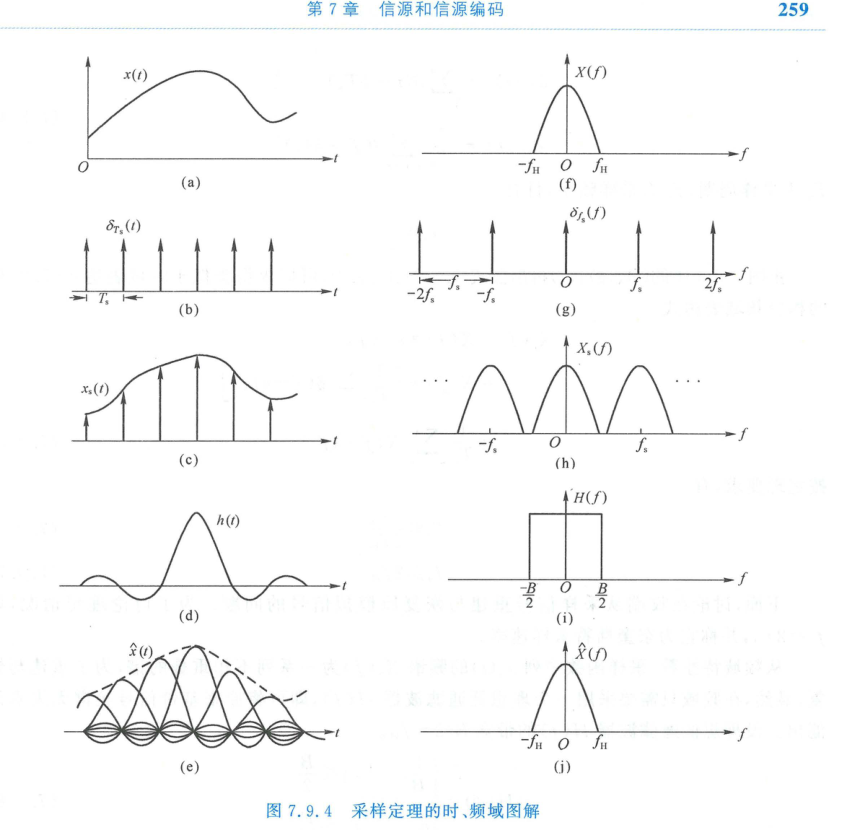
奈奎斯特采样准则
Section titled “奈奎斯特采样准则”为了使频谱周期延拓时不发生频谱交叠,各延拓副本之间的间隔必须满足:
fₛ - f_H ≥ f_H implies fₛ ≥ 2 f_H- fₛ,min = 2 f_H 称为奈奎斯特速率(Nyquist Rate);
- 对应最大允许抽样时间间隔为奈奎斯特间隔:Tₛ,max = (1)/(2 f_H)。
理想重建公式(惠特克-香农内插公式)
Section titled “理想重建公式(惠特克-香农内插公式)”只要满足 fₛ ≥ 2 f_H,将抽样信号 xₛ(t) 馈入通带增益为 Tₛ、截止频率为 f_H 的理想矩形低通滤波器,在时域上对应与 operatornamesinc 函数的卷积,原连续信号可百分之百无失真精确重构:
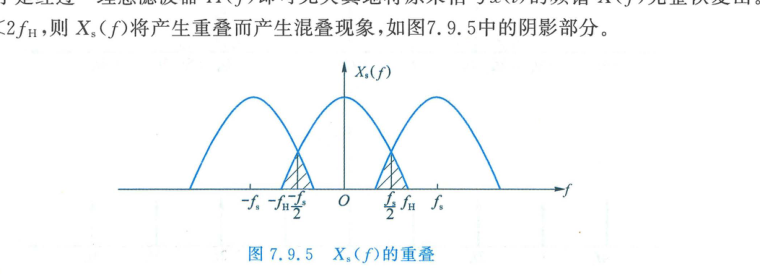
x(t) = ∑ₖ=-∞^(∞) x(k Tₛ) operatornamesinc((t - k Tₛ)/(Tₛ)) = ∑ₖ=-∞^(∞) x(k Tₛ) (sin[π (t - k Tₛ)/Tₛ])/(π (t - k Tₛ)/Tₛ)若采样频率不足(fₛ < 2 f_H),高频成分将折叠进入低频带,产生不可逆的混叠失真(Aliasing):
2. 带通采样定理(Bandpass Sampling Theorem)
Section titled “2. 带通采样定理(Bandpass Sampling Theorem)”在无线中频接收与软件无线电(SDR)中,信号常呈现带通特性,频带限制在 [f_L, f_H],绝对带宽 B = f_H - f_L。若直接应用低通采样定理,采样频率需达到 fₛ ≥ 2 f_H,当载频极高时对 ADC 硬件器件提出极端挑战。
带通采样定理指出:通过精心选择采样频率,使频谱周期延拓副本恰好填满频带间隙而不重叠:
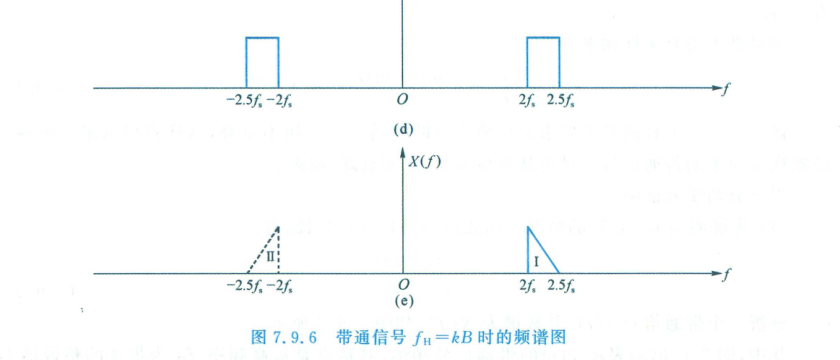
令 k = lfloor f_H / B rfloor 为最高频率包含带宽的最大整数倍,无混叠的带通最小采样频率为:
fₛ,min = (2 f_H)/(k) = 2B(1 + (r)/(k B))式中 r = f_H - k B 为余数(0 ≤ r < B)。
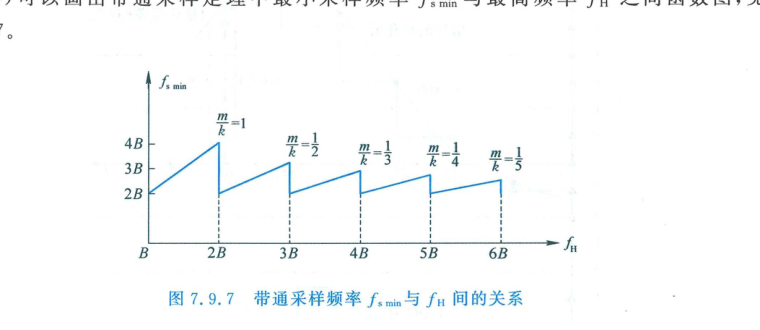
带通采样的最低速率始终落在 2B ≤ fₛ ≤ 4B 之间,极大降低了对超高速模数转换器的物理带宽苛求。
7.9.3 标量量化(Scalar Quantization)
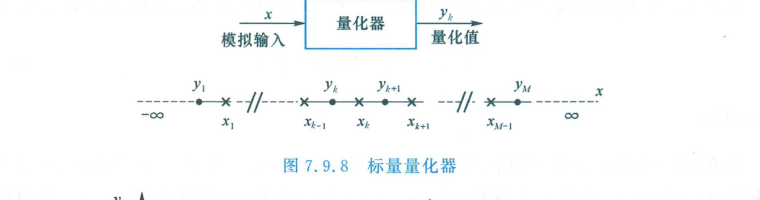
Section titled “7.9.3 标量量化(Scalar Quantization)”标量量化器是将时间连续样值信号 x 映射为离散量化电平 yₖ 的非线性运算器:
1. 均匀量化与量化信噪比(SQNR)
Section titled “1. 均匀量化与量化信噪比(SQNR)”若输入信号动态范围为 [-V, +V],被划分为 M 个等间距量化区间,每个量化间隔为:
Δ = (2V)/(M) = (2V)/(2^N)式中 N = log₂ M 为量化编码位数。
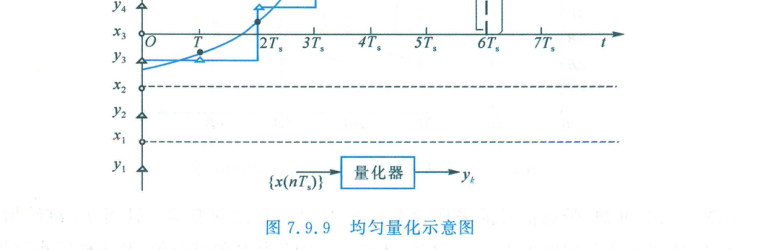
量化误差 e_q = x - yₖ 在 [-(Δ)/(2), +(Δ)/(2)] 内服从均匀分布,其量化噪声功率为:
σ_q² = ∫_(-Δ/2)^(Δ/2) e² (1)/(Δ) de = (Δ²)/(12)对于峰值幅度为 V 的满幅正弦交流信号,信号功率为 S = (V²)/(2)。信号量化噪声比(SQNR)为:
SQNR = 10 log₁0((S)/(σ_q²)) = 10 log₁0((V² / 2)/((2V / 2^N)² / 12)) = 10 log₁0(3/2 · 2²N)展开计算得到著名的数字音频/通信 6 dB 定则:
SQNR = 6.02 N + 1.76 (dB)物理规律:量化器每增加 1 bit 编码精度,量化信噪比提升约 6 dB。
2. 劳埃德-麦克斯(Lloyd-Max)最佳标量量化准则
Section titled “2. 劳埃德-麦克斯(Lloyd-Max)最佳标量量化准则”对于非均匀分布的连续信源,均匀量化并非均方误差最小的最优量化。 在均方失真 D = ∑ₖ=1^M ∫ₓₖ-1ˣₖ (x - yₖ)² p(x)dx 达到极小时,判决门限 {xₖ} 与量化电平 {yₖ} 必须严格满足两组互锁正交条件:
- 最佳判决门限(中点条件): xₖ = fracyₖ + yₖ+12 分层门限电平应恰好位于相邻两个重建量化电平的算术中点;
- 最佳量化电平(概率质心条件): yₖ = frac∫ₓₖ-1ˣₖ x p(x)dx∫ₓₖ-1ˣₖ p(x)dx = E[X | X ∈ (xₖ-1, xₖ)] 每个量化区间的输出值应为其在对应区间内的条件统计概率质心。
3. 非均匀量化与对数压扩(Companding)
Section titled “3. 非均匀量化与对数压扩(Companding)”在语音通信中,小幅度样值出现的概率极高(服从拉普拉斯分布),大信号出现概率极低。若采用均匀量化,小信号落入固定步长 Δ 时,相对误差极大,信噪比严重恶化:
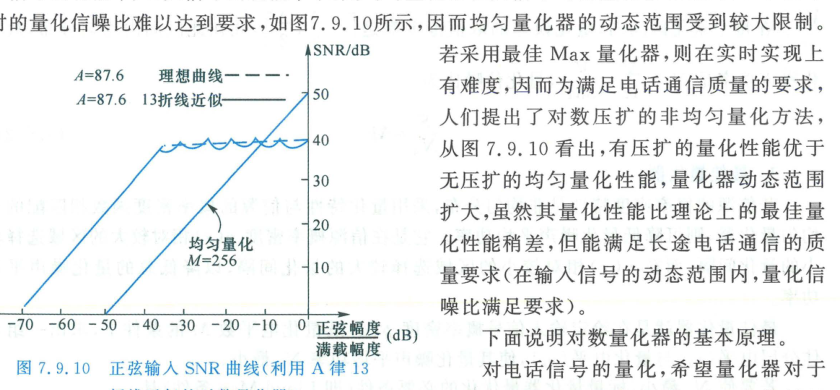
为了在宽达 40 ∼ 50 dB 的动态范围内维持恒定高信噪比,工程上普遍采用压扩技术(Companding):
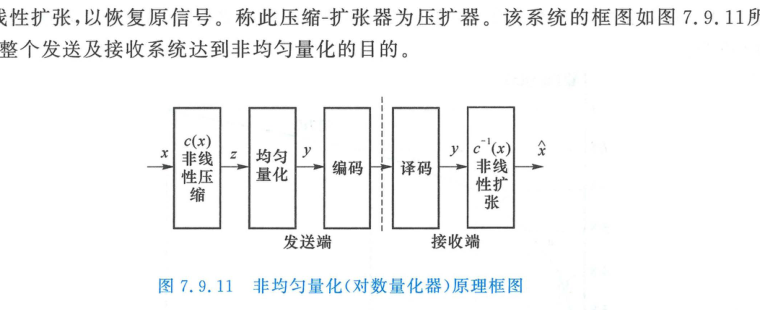
国际对数压扩标准
Section titled “国际对数压扩标准”国际电信联盟(ITU-T G.711)推荐了两大经典标准:
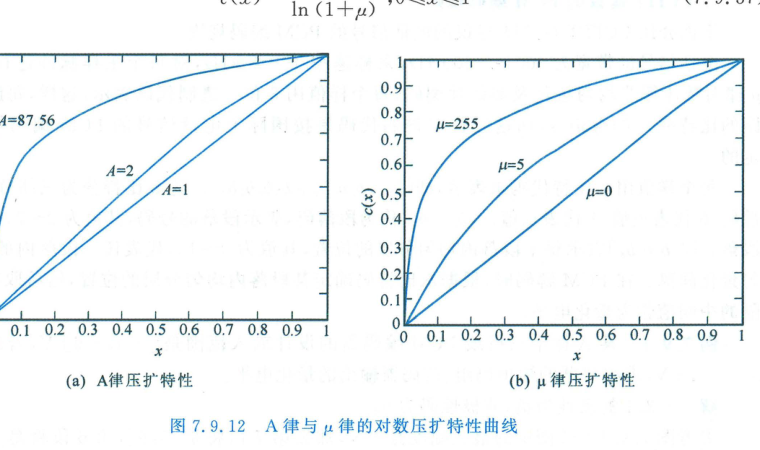
- A 律压扩(欧洲与中国采用,指定标准 A = 87.56): y = (A x)/(1 + ln A), & 0 ≤ x ≤ 1/A (1 + ln(A x))/(1 + ln A), & 1/A < x ≤ 1
- μ 律压扩(北美与日本采用,指定标准 μ = 255): y = (ln(1 + μ x))/(ln(1 + μ)), 0 ≤ x ≤ 1
4. A 律 13 折线与 8 位 PCM 编码算法
Section titled “4. A 律 13 折线与 8 位 PCM 编码算法”在数字硬件实现中,平滑对数曲线难以精确用电路实现。工程上普遍采用 A 律 13 折线(13-Segment Characteristic) 逼近理论 A 律曲线。
将正负输入电压归一化范围 [-1, +1] 沿横轴非均匀划分为 8 个不等长区间,各段边界依次按 1/2 几何级数二等分收缩:[0, (1)/(128), (1)/(64), (1)/(32), (1)/(16), 1/8, 1/4, 1/2, 1]。
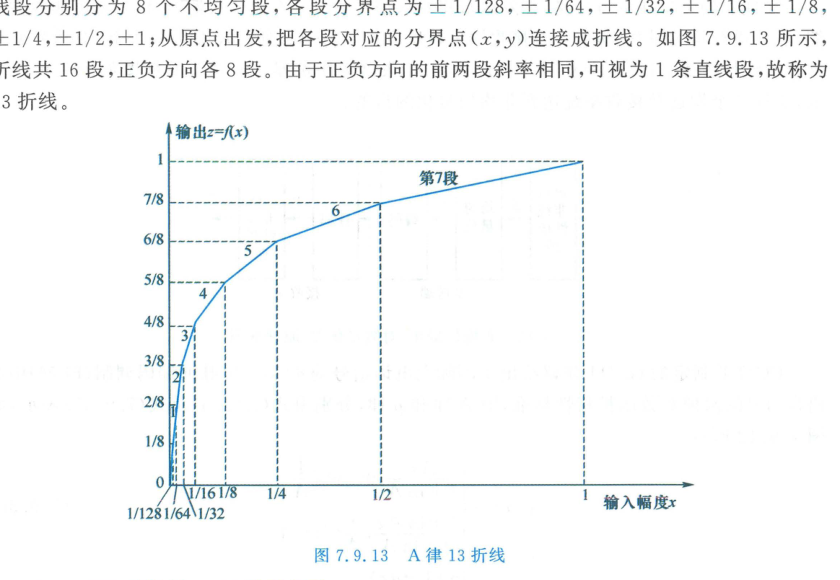
由于正负第一段在原点处斜率相同(均为 16)并呈一条直线,正负极性共 8 × 2 - 2 = 14 段中合并中心 2 段,实际构成 13 段线性折线。
8 位 PCM 码字结构
Section titled “8 位 PCM 码字结构”每个抽样值被编码为一个标准的 8 比特字节(C1 C2 C3 C4 C5 C6 C7 C8):
- C₁(极性码,1 bit):判断样值符号。正极性取
1,负极性取0; - C₂ C₃ C₄(段落码,3 bit):标识样值落在正(或负)极性的哪一个折线段内(段落号 0 ∼ 7,对应代码
000到111); - C₅ C₆ C₇ C₈(段内码,4 bit):在确定的折线段内,均匀细分 16 个量化量化级,标识样值落在段内的具体位置(0 ∼ 15)。
| 段号 | 段落码 C₂ C₃ C₄ | 归一化输入电平范围 | 段落起始归一化电平 | 段内每个量化级步长 Δᵢ |
|---|---|---|---|---|
| 1 | 000 | [0, 1/128) | 0 | 1/2048 |
| 2 | 001 | [1/128, 1/64) | 16/2048 | 1/2048 |
| 3 | 010 | [1/64, 1/32) | 32/2048 | 2/2048 |
| 4 | 011 | [1/32, 1/16) | 64/2048 | 4/2048 |
| 5 | 100 | [1/16, 1/8) | 128/2048 | 8/2048 |
| 6 | 101 | [1/8, 1/4) | 256/2048 | 16/2048 |
| 7 | 110 | [1/4, 1/2) | 512/2048 | 32/2048 |
| 8 | 111 | [1/2, 1] | 1024/2048 | 64/2048 |
设输入模拟电压信号的最大允许动态范围为 [-6 V, +6 V],当前抽样样值电压为 x = +1.35 V。 试求解:
- 该抽样值的 8 位 PCM 编码码字;
- 译码器重构恢复后的电压(取段内量化级中点),并计算量化绝对误差。
解
(1) 归一化与极性判断: 输入电压为正,故极性码:
C₁ = 1归一化幅度电平(将最大峰值 6 V 线性映射为全量程 2048 个量化单位):
Xₙorm = (1.35 V)/(6.0 V) × 2048 = 460.8 单位(2) 确定段落码 C₂ C₃ C₄: 查表对照各段起始电平范围(单位数):
- 第 5 段(段落码
100):128 ∼ 256 - 第 6 段(段落码
101):256 ∼ 512 由于 256 ≤ 460.8 < 512,该样值落入第 6 段。 故段落码为:
(3) 确定段内码 C₅ C₆ C₇ C₈: 第 6 段起始电平为 256 单位,段内量化级步长为 Δ₆ = 16 单位。 样值超出起始电平的量为:
δ = 460.8 - 256 = 204.8 单位计算落入第几级:
m = lfloor (204.8)/(16) rfloor = lfloor 12.8 rfloor = 12将整数 12 转换为 4 位二进制段内码(12 = 8 + 4):
C₅ C₆ C₇ C₈ = 1100合成 8 位 PCM 输出码字:
Code = 11011100(4) 译码重构与量化误差: 译码端按段内中心电平重建(第 12 级的中心位置为 12 + 0.5 = 12.5 步长):
Yₙorm = 256 + 12.5 × 16 = 256 + 200 = 456 单位换算回实际物理重构模拟电压:
y = (456)/(2048) × 6.0 V ≈ 1.3359 V产生的绝对量化误差为:
e_q = x - y = 1.3500 - 1.3359 = +0.0141 V (+4.8 单位)量化误差严格落在半步长范围(± 0.5 Δ₆ = ± 8 单位)内。
7.9.4 时分复用(Time-Division Multiplexing, TDM)与 PCM 基群
Section titled “7.9.4 时分复用(Time-Division Multiplexing, TDM)与 PCM 基群”由于单路话音信号经 8 kHz 抽样后产生的窄脉冲宽度极窄,样值之间存在大量的空闲时间。时分复用(TDM) 利用这部分空闲时间交织传送多个话路的信号:
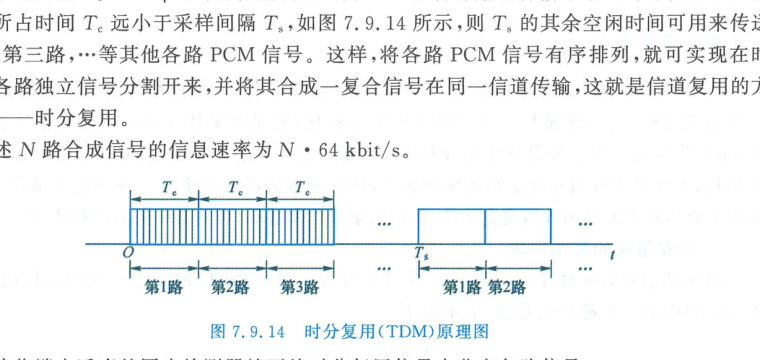
1. 欧洲与中国标准:PCM 30/32 路基群(E1 系统)
Section titled “1. 欧洲与中国标准:PCM 30/32 路基群(E1 系统)”国际电报电话咨询委员会(CCITT/ITU-T)规定的 PCM 30/32 路一次群帧结构是全球主流基准:
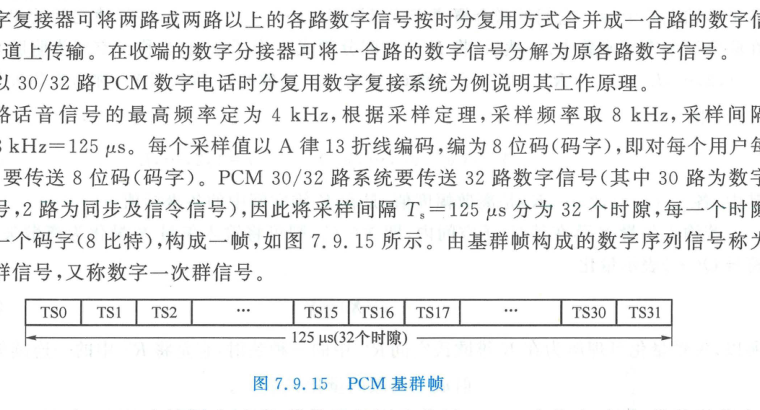
- 抽样频率与帧周期:话音截止频率 3.4 kHz,标准采样频率 fₛ = 8000 Hz,对应帧周期为: T_f = (1)/(fₛ) = 125 μs
- 时隙划分:每帧包含 32 个均匀时隙(TS₀ ∼ TS₃1),每个时隙宽度为 (125 μs)/(32) ≈ 3.9 μs,分配 8 比特;
- 业务分配:
- TS₀:专用于传送帧同步码(偶帧)与网管告警标志(奇帧);
- TS₁6:专用于传送信令(复帧多路信令交互);
- 其余 30 个时隙(TS₁ ∼ TS₁5 与 TS₁7 ∼ TS₃1)用于承载 30 路独立话音业务;
- 总传输数率: R_(E1) = (32 × 8 bit)/(125 μs) = 256 × 8000 = 2.048text Mbit/s
2. 北美与日本标准:PCM 24 路基群(T1 系统)
Section titled “2. 北美与日本标准:PCM 24 路基群(T1 系统)”- 包含 24 路话音时隙,每时隙 8 bit,每帧末尾追加 1 位专用帧同步比特,每帧总位数 24 × 8 + 1 = 193 bit;
- 总传输速率: R_(T1) = 193 × 8000 = 1.544text Mbit/s
7.9.5 矢量量化(Vector Quantization, VQ)
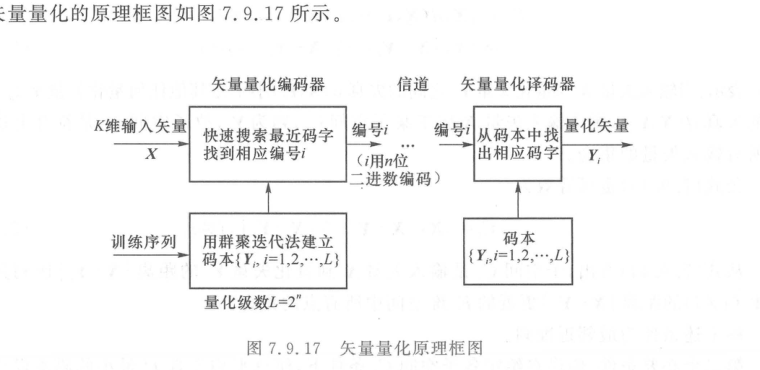
Section titled “7.9.5 矢量量化(Vector Quantization, VQ)”标量量化是对单一样值独立量化。1980 年代发展的矢量量化(Vector Quantization, VQ) 将 K 个连续样点打包为 K 维欧氏空间矢量 X = (X₁, X₂, …, X_K)^T 实施联合量化。
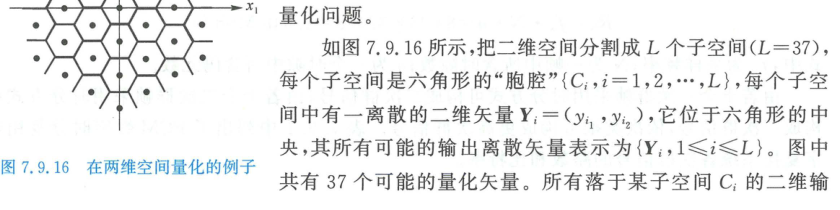
1. 矢量量化器的运行机理
Section titled “1. 矢量量化器的运行机理”- 码书建立:预先训练生成包含 L 个代表矢量的码书 mathcalY = {Y₁, Y₂, …, Y_L};
- 最近邻匹配编码:对任意输入矢量 X,在码书中搜索欧氏距离最近的码字: |X - Yᵢ|² = minⱼ |X - Yⱼ|² 信道中仅需传输该最佳码字的索引序号 i(仅需 log₂ L 比特);
- 查表重建:接收端根据接收索引 i 直接查表输出矢量 Yᵢ。
2. 矢量量化的压倒性增益来源(香农结论)
Section titled “2. 矢量量化的压倒性增益来源(香农结论)”即使各样点在统计上完全独立,矢量量化依然全面超越标量量化:
- 超球充填增益(Sphere-Packing Gain):在多维空间中,Voronoi 胞腔形状逼近高维超球体,比一维/二维的超立方体晶格具有更紧凑的表面积体积比;
- 非线性记忆与相关性利用:天然吸收样点间的互协方差与高阶相关性,成为现代低速率语音编码(CELP)与深度学习端到端神经图像压缩的核心构件。