
7.5 节的香农第一定理指出了无失真数据压缩的理论极限 —— 平均码长可以无限逼近信源信息熵 H(X)。本节重点探讨如何通过具体的构造性算法实现这种极致的压缩,核心代表即为哈夫曼(Huffman)编码。
7.6.1 变长码与前缀码原理
Section titled “7.6.1 变长码与前缀码原理”在变长信源编码中,不同信源符号被赋予不同长度的代码。为了确保在接收端接收到连续不断的比特流时,无需在符号之间插入专门的“逗号”或分隔符就能即时、唯一、无歧义地划分出每个码字,所设计的变长码必须是唯一可译码(Uniquely Decodable Code)。
1. 前缀码(瞬时码)定义
Section titled “1. 前缀码(瞬时码)定义”在一个变长码集中,如果没有任何一个码字是其他任何长码字的前缀(即开头部分),则称该码为前缀码或无前缀码(Prefix-Free Code)。
前缀码具有即时可译性(Instantaneous):解码器从左至右扫描接收比特流,一旦识别出某一段比特与码本中某一码字完全吻合,便可立即断定该符号结束并完成译码,绝不需要等待后续比特。
2. 克拉夫特不等式(Kraft Inequality)
Section titled “2. 克拉夫特不等式(Kraft Inequality)”设代码字母表基数为 m(二进制时 m = 2),信源包含 n 个离散符号,各码字的长度分别为 K₁, K₂, …, Kₙ。 前缀码存在的充要条件是各码长满足著名的克拉夫特不等式:
∑ᵢ=1ⁿ m⁻Kᵢ ≤ 1设有一离散无记忆信源 mathcalX = {x₁, x₂, x₃, x₄},各符号概率分别为:
mathcalX P(x) = x₁ & x₂ & x₃ & x₄ 1/2 & 1/4 & 1/8 & 1/8采用如下单符号变长码:
- x₁ → 0(码长 K₁ = 1)
- x₂ → 10(码长 K₂ = 2)
- x₃ → 110(码长 K₃ = 3)
- x₄ → 111(码长 K₄ = 3)
试验证其前缀特性并求解编码效率。
解
(1) 前缀特性验证: 码字集为 {0, 10, 110, 111}。码字 0 不是其余任何码字的前缀;码字 10 亦不是 110 或 111 的前缀。各码长满足克拉夫特不等式:
2⁻1 + 2⁻2 + 2⁻3 + 2⁻3 = 1/2 + 1/4 + 1/8 + 1/8 = 1.0 ≤ 1故为完全前缀瞬时码。
(2) 求解信息熵与平均码长: 信源符号信息熵为:
H(X) = -[ 1/2log₂1/2 + 1/4log₂1/4 + 2 × 1/8log₂1/8 ] = 1/2(1) + 1/4(2) + 1/4(3) = 7/4 = 1.75 bit/symbol单符号逐个编码(L=1)时的平均码长为:
barK = ∑ᵢ=1⁴ P(xᵢ) Kᵢ = 1/2(1) + 1/4(2) + 1/8(3) + 1/8(3) = 7/4 = 1.75 bit/symbol(3) 求解编码效率:
η = fracH(X)barK = (1.75)/(1.75) = 100%结论:当信源符号的先验概率恰好均为 2 的负整数次幂(即 P(xᵢ) = 2⁻Kᵢ)时,变长前缀码对单个符号编码即可达到 100% 的理论香农熵极限!
7.6.2 哈夫曼(Huffman)最优前缀编码
Section titled “7.6.2 哈夫曼(Huffman)最优前缀编码”1952 年,麻省理工学院博士生大卫·哈夫曼(David A. Huffman)提出了一种自底向上的最优前缀二叉树构造算法。数学已严格证明:在所有针对离散无记忆信源的符号级唯一可译前缀码中,哈夫曼编码具有最小的平均码长。
1. 哈夫曼编码标准五步法
Section titled “1. 哈夫曼编码标准五步法”graph TD
A["步骤 1:降序排列<br/>将全部 n 个符号按先验概率由大到小排列"] --> B["步骤 2:底端合并<br/>挑选概率最小的两节点作为兄弟,分别分配 0 与 1"]
B --> C["步骤 3:概率求和生成复合节点<br/>将合并后的新概率重新按序插入剩余符号列中"]
C --> D{"步骤 4:迭代判定<br/>是否已聚合至根节点(概率为 1.0)?"}
D -- 否 --> B
D -- 是 --> E["步骤 5:自顶向下回溯逆寻<br/>从根节点沿路径顺次记录分支 0/1 得到对应唯一码字"]
设有一离散单符号信源包含 7 个独立符号:
mathcalX P(x) = x₁ & x₂ & x₃ & x₄ & x₅ & x₆ & x₇ 0.20 & 0.19 & 0.18 & 0.17 & 0.15 & 0.10 & 0.01试对其进行二进制哈夫曼编码,并求解其平均码长与编码效率。
解
根据哈夫曼编码规则,自底向上合并最小概率节点:
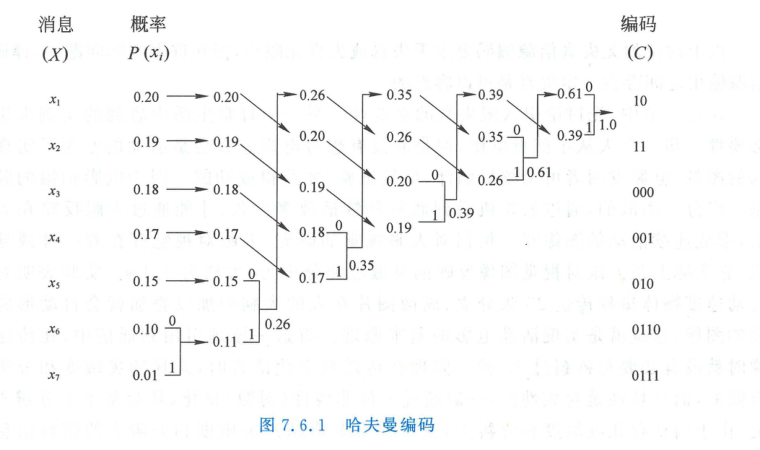
缩减合并演化步骤:
- 初始概率降序排布:0.20, 0.19, 0.18, 0.17, 0.15, 0.10, 0.01;
- 最小两项为 x₆(0.10) 与 x₇(0.01),合并为 0.11(赋分支 0, 1);
- 剩余序列重排:0.20, 0.19, 0.18, 0.17, 0.15, 0.11;
- 最小两项为 0.15 与 0.11,合并为 0.26;
- 剩余序列重排:0.26, 0.20, 0.19, 0.18, 0.17;
- 最小两项为 0.18 与 0.17,合并为 0.35;
- 剩余序列重排:0.35, 0.26, 0.20, 0.19;
- 最小两项为 0.20 与 0.19,合并为 0.39;
- 剩余序列重排:0.39, 0.35, 0.26;
- 最小两项为 0.35 与 0.26,合并为 0.61;
- 最终两项为 0.39 与 0.61,合并为 1.00(根节点)。
从根节点沿路径自顶向下回溯,得到各符号的码字分配:
| 符号 | 概率 P(xᵢ) | 哈夫曼码字 | 码长 Kᵢ |
|---|---|---|---|
| x₁ | 0.20 | 10 | 2 |
| x₂ | 0.19 | 11 | 2 |
| x₃ | 0.18 | 000 | 3 |
| x₄ | 0.17 | 001 | 3 |
| x₅ | 0.15 | 010 | 3 |
| x₆ | 0.10 | 0110 | 4 |
| x₇ | 0.01 | 0111 | 4 |
(1) 求解信源信息熵:
H(X) = -∑ᵢ=1⁷ P(xᵢ) log₂ P(xᵢ) ≈ 2.61 bit/symbol(2) 求解平均码长:
barK &= ∑ᵢ=1⁷ P(xᵢ) Kᵢ &= 0.20(2) + 0.19(2) + 0.18(3) + 0.17(3) + 0.15(3) + 0.10(4) + 0.01(4) &= 0.40 + 0.38 + 0.54 + 0.51 + 0.45 + 0.40 + 0.04 = 2.72 bit/symbol(3) 求解编码效率与冗余度:
η = fracH(X)barK = (2.61)/(2.72) ≈ 95.96%γ = 1 - η ≈ 4.04%若采用等长编码,7 个符号至少需要 K = lceil log₂ 7 rceil = 3 bit。哈夫曼编码使平均码长缩短至 2.72 bit,显著提高了传输有效性。
7.6.3 哈夫曼编码的工程特性与现代衍生
Section titled “7.6.3 哈夫曼编码的工程特性与现代衍生”- 码字分配的非唯一性:
- 兄弟分支分配
0或1是任意对偶的; - 当多个中间复合节点具有相同概率时,重排次序的选择不唯一。
- 数学结论:不同的分配树会产生形式不同的码本,但最终计算所得的平均码长 barK 是唯一确定的,且绝对达到理论最小值。
- 兄弟分支分配
- 对先验概率的强依赖性:
- 哈夫曼编码的最佳性完全建立在“信源概率统计特性精准已知且长期平稳”的严苛假设下;
- 若实际信源概率漂移或未知,哈夫曼码将失去匹配性,压缩效率急剧恶化。
- 工程扩展与实用无失真编码演进:
- 游程编码(Run-Length Encoding, RLE):传真与二值图文编码的工业标准。将连续重复的相同比特串(如“白游程”与“黑游程”长度)作为扩展消息,再对其运行哈夫曼统计编码;
- 算术编码(Arithmetic Coding):摆脱了哈夫曼编码必须为每个符号分配整数比特的结构约束,将整个消息序列映射为 [0, 1) 实数区间中的一个子区间,特别适用于自适应动态信源压缩;
- 字典编码(Lempel-Ziv / LZ77 / LZ78 / LZW):无需预先获知任何先验概率模型,自适应建立字符串滑动窗口字典。奠定了现代计算机网络通用压缩算法(Gzip, PNG, ZIP, 7z)的核心基础。